デフォルト確率の推定値は、どこまで信じてよいか:少数データとブートストラップ
はじめに
ある格付け区分の過去5年をさかのぼると、デフォルトは12件でした。対象は500社なので、のべ2,500の「社・年」を観測して12件、割り算するとデフォルト率は0.48%です。この0.48%を来期のデフォルト確率(PD、Probability of Default)として、貸倒引当の水準や、規制上持つべき資本の計算に使ってよいでしょうか。
この問いが難しいのは、データを増やして解決できないからです。デフォルトはめったに起きないからこそリスクとして測りたいのに、めったに起きないからこそ観測が集まりません。観測年数を延ばせば古い景気局面や昔の審査基準が混ざってしまいます。信用リスクモデリングの実務では、優良先ばかりでデフォルト実績がほとんどない区分(低デフォルトポートフォリオ、low default portfolio)のPD推定が定番の難所で、12件というのはむしろ恵まれた部類です。
この記事では、12件から計算した推定値が統計的にどれだけ揺れるのかを、合成データの数値実験で測ります。観測をやり直せたとしたら推定値はどの範囲に収まりうるか(信頼区間)を複数の方法で計算し、手元のデータを引き直して推定を何度も繰り返すブートストラップ(bootstrap)で、年ごとの景気の波が区間をさらに広げることを確かめます。この幅を規制資本の式に通すと、必要資本の見積もりは区間の下端と上端でおよそ2倍動きます。PD推定が信用リスク管理全体のどこに位置するかは、信用リスク管理の全体像で整理しています。
対象読者:
- 信用リスクモデルや格付け制度の開発・検証に関わる方
- デフォルト・重大クレーム・設備故障など、まれな事象の発生率を少ないデータから見積もる方
- 点推定の1つの数字で進んでいる引当・必要資本の議論に、幅の情報を持ち込みたい方
記事のポイント:
- 12件/2,500社・年の点推定0.48%に対し、正確な二項区間(Clopper-Pearson)は0.25%〜0.84%で、区間の幅は点推定そのものより広くなります
- デフォルトは景気で年ごとにまとまって起きるため、社・年の独立を仮定した区間は狭すぎます。年単位で引き直すブートストラップでは幅が1.8倍になります
- Beta事前分布によるベイズ更新で「0.5%程度のはず」という意見と実績12件を混ぜ、事前分布の選択が後から監査できる形で残ることの実務価値を示します
500社を5年観測して、デフォルトは12件
扱うデータは、1行が1つの「社・年」です。ある企業のある年度について、期初に与信残高があったか、その年度中にデフォルトしたかを記録します。例えば「企業0217・3年目・デフォルトなし」で1行です。500社×5年でのべ2,500行になり、そのうち「デフォルトあり」は12行でした。
推定は割り算1回で、 です。ここまでに統計モデルは登場せず、以降の問題はすべて「この割り算の分子が12件しかない」ことから生じます。分子が1件増えるか減るかだけで、点推定は 変わります。
実在の顧客データはこの用途に使えないため、以降の数値は合成データで作ります。各年の景気を表す共通因子で全社のデフォルト確率が同時に上下する1ファクターモデルから、真のPDを0.5%、資産相関を0.15として生成しました。生成する分布を知っている(真の値が0.5%だと分かっている)ことが、推定の揺れを評価するうえでの利点です。
import numpy as np
from scipy.stats import norm, beta as beta_dist

TRUE_PD = 0.005   # 生成モデル側の真のPD
RHO = 0.15        # 資産相関
N_OBLIGORS = 500
N_YEARS = 5

rng = np.random.default_rng(360)
z = rng.standard_normal(N_YEARS)  # 各年の景気因子
p_year = norm.cdf((norm.ppf(TRUE_PD) - np.sqrt(RHO) * z) / np.sqrt(1 - RHO))
defaults = rng.binomial(N_OBLIGORS, p_year)  # 年ごとのデフォルト件数
生成された年ごとの件数を並べます。
| 年 | デフォルト件数 | 年次デフォルト率 |
|---|---|---|
| 1年目 | 0 | 0.00% |
| 2年目 | 1 | 0.20% |
| 3年目 | 1 | 0.20% |
| 4年目 | 2 | 0.40% |
| 5年目 | 8 | 1.60% |
12件は5年に均等に散らばってはいません。残りの4年は合わせて4件にとどまり、5年目に8件がまとまって出ています。生成モデルを知らずにこの表だけを見ても、与信の担当者なら「5年目は景気後退の年だ」と読むはずです。デフォルト実績が1件もない年があるのも、低デフォルトポートフォリオでは普通の光景です。
95%区間は0.25%〜0.84%に広がり、幅は点推定を超える
信頼区間の発想はこうです。同じ500社の5年間をもう一度観測し直せたとしても、デフォルトがちょうど12件になるとは限りません。10件かもしれないし、15件かもしれません。観測のやり直しで推定値が動きうる範囲を数字にしたものが信頼区間で、95%区間なら「やり直しの95%でこの範囲に収まる」ように作ります。
まず、社・年ごとの観測が互いに独立に同じ分布から出ている(i.i.d.)と仮定して、3つの方法で95%区間を出します。教科書の正規近似(、Wald区間)、二項分布の裾の確率を直接使う正確な区間(Clopper-Pearson区間)、そして2,500行を復元抽出で引き直して割り算を繰り返すブートストラップです。行の復元抽出は二項分布からの乱数と数学的に同じなので、実装は数行で済みます。
k, n = defaults.sum(), N_OBLIGORS * N_YEARS   # 12, 2500
p_hat = k / n                                  # 0.0048
alpha = 0.05

# Clopper-Pearson(正確な二項区間)
cp_lo = beta_dist.ppf(alpha / 2, k, n - k + 1)
cp_hi = beta_dist.ppf(1 - alpha / 2, k + 1, n - k)

# i.i.d.ブートストラップ(2,500行の復元抽出は二項乱数1回と同じ)
B = 200_000
rng_boot = np.random.default_rng(1)
boot_iid = rng_boot.binomial(n, p_hat, size=B) / n
iid_lo, iid_hi = np.percentile(boot_iid, [2.5, 97.5])
結果を並べます。
| 方法 | 95%区間 | 幅 |
|---|---|---|
| 正規近似(Wald) | 0.21%〜0.75% | 0.54% |
| Clopper-Pearson | 0.25%〜0.84% | 0.59% |
| i.i.d.ブートストラップ | 0.24%〜0.76% | 0.52% |
どの方法でも幅は0.5%を超え、Clopper-Pearson区間の幅0.59%は点推定0.48%の1.2倍です。区間の上端0.84%は下端0.25%の3.4倍にあたります。つまり「0.48%」という小数点以下2桁の見た目が持つ精度に、実体はありません。真のPDが0.3%でも0.8%でも、12件前後の観測は普通に起こります。なお生成モデルの真の値0.5%は、3つの区間のいずれにも含まれています。
正規近似が他よりやや狭く出ている点にも触れておきます。件数が1桁〜十数件の領域では正規近似は粗く、下端が0%に近づく(さらに少ないと負になる)ゆがみ方をします。少数デフォルトの区間には、正確な二項区間かブートストラップを使います。
追加で考慮すべきこと: デフォルト相関
ここまでの区間には、まだ楽観が残っています。3つの方法はいずれも、2,500の社・年が互いに独立に、確率0.48%で表が出るコインを投げていると仮定しますが、年ごとの件数表が示すとおり、デフォルトは悪い年に固まって出ます。景気が悪化した年は全社のデフォルト確率が同時に上がるためで、この共変動が損失分布に何をするかはデフォルト相関と損失の裾の記事で扱っています。独立の仮定はデータの実効的な量を過大に見積もり、区間を狭くしすぎます。
年の共変動を区間に反映する簡便な方法が、引き直しの単位を行から年に変えたブートストラップです。5年分の年次件数から復元抽出で5年を選び直し、合計し直した件数でPDを再計算します。悪い年を含めた「年のセット」ごと引き直すので、年の中の相関を壊さずに済みます。
idx = rng_boot.integers(0, N_YEARS, size=(B, N_YEARS))  # 年を引き直す
boot_block = defaults[idx].sum(axis=1) / n
blk_lo, blk_hi = np.percentile(boot_block, [2.5, 97.5])
この手続きが実際に何をしているかを、最初の5回分で見せます。
| 引き直した年 | 件数の合計 | PDの再計算値 |
|---|---|---|
| 4, 3, 3, 4, 2年目 | 7 | 0.28% |
| 2, 4, 4, 5, 1年目 | 13 | 0.52% |
| 4, 5, 5, 2, 5年目 | 27 | 1.08% |
| 1, 5, 4, 3, 5年目 | 19 | 0.76% |
| 1, 3, 5, 4, 4年目 | 13 | 0.52% |
1回目の引き直しは悪い年(5年目、8件)を1度も含まないので7件にとどまり、3回目は悪い年を3度引いたので27件まで膨らみます。悪い年を何回引くかで推定値が段になって動くのが、年単位で引き直すことの中身です。
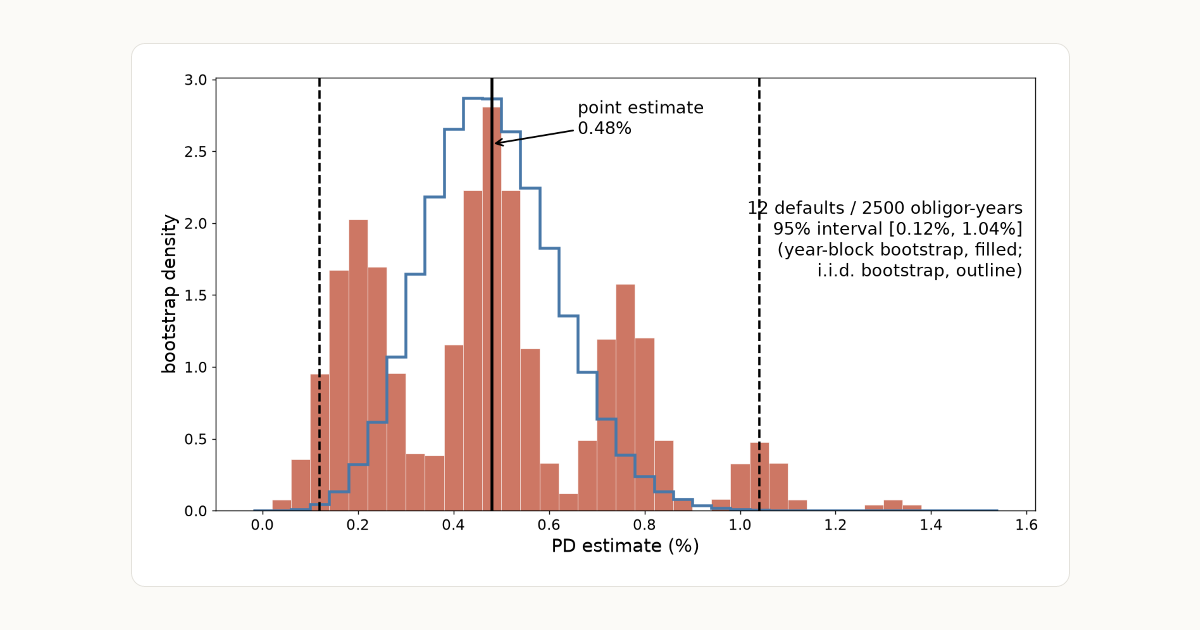
区間は0.12%〜1.04%になり、幅0.92%はi.i.d.ブートストラップの幅0.52%の1.8倍です。分布を重ねて描くと、独立の仮定が区間をどれだけ狭く見せていたかが分かります。
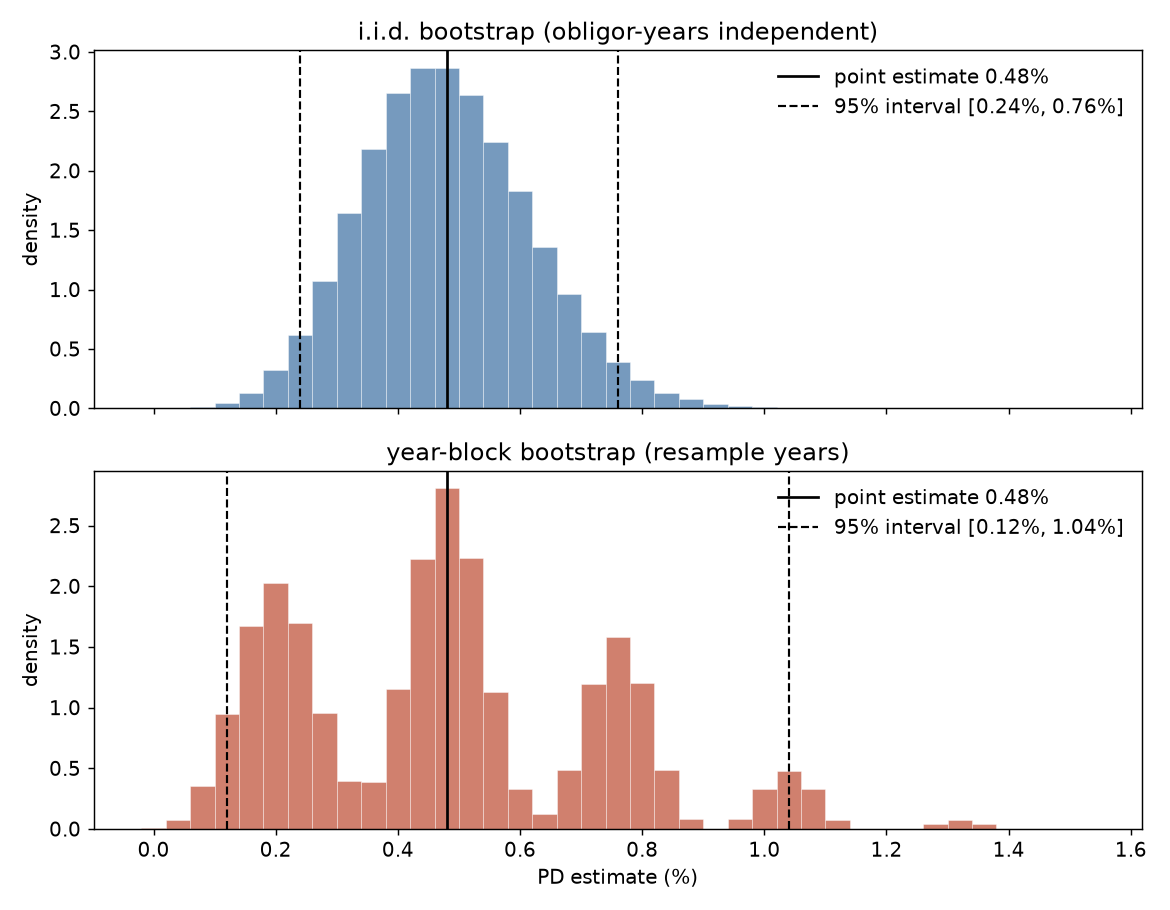
下段の年ブロック側に山が4つ見えるのは、引き直しに悪い年が0回・1回・2回・3回入った場合に対応します。実務上の違いが出るのは裾です。推定PDが0.8%以上になる確率は、独立仮定では2.1%ですが、年を引き直すと12.9%まで上がります。「0.8%を超えることはほぼない」と言えるかどうかが、仮定ひとつで6倍変わります。
この年ブロックブートストラップにも粗さがあります。ブロックが5個しかないため年効果の分散を控えめにしか捉えられず、真の不確実性はさらに大きい可能性があります。観測年数が十分あれば、年効果をランダム効果として置く階層モデルで推定する選択肢もあります。それでも「独立を仮定した区間は狭すぎる」という結論は変わらないので、少数データの区間はまず年単位で引き直して確かめます。
5年平均のPDを使うこと自体にも設計判断が含まれています。景気に追随する推定(point-in-time)を狙うのか、景気循環をならした長期平均(through-the-cycle)を狙うのかで、観測期間の取り方も区間の読み方も変わります。この記事の5年窓には悪い年が1つ入っていますが、5年が景気の一巡に足りているかは別に検討が要る問いで、窓の取り方の違いは区間の幅より大きな差を生むこともあります。
経験と観測事実のマージ
モデル検証の場では、数字と別の種類の情報が出てきます。「類似ポートフォリオを長く見てきた経験では、この区分は0.5%前後のはずだ」という担当者の意見です。12件しかないデータを前に、この意見を無視するのも、逆に点推定を意見で上書きするのも乱暴です。両者を混ぜる標準的な道具がベイズ更新で、意見を確率分布(事前分布)として書き、データで更新して事後分布を得ます。考え方の背景は頻度主義とベイズの比較記事に書きました。
二項データにはBeta分布を事前分布に使うと、更新が足し算だけで済みます。事前分布 は「仮想的に 件のデフォルトと 件の非デフォルトをすでに見ている」ことに相当し、実データ(、)を観測した後の分布は次で与えられます。
事前分布は平均と強さで決めます。平均は意見の0.5%に置き、強さ は「その意見を何社・年分の観測に相当するとみなすか」です。平均の出どころにも実務の型があり、外部格付機関が公表する長期デフォルト率と内部格付の対応付けや、類似する別ポートフォリオの実績が使われます。信用スコアリングの案件で見てきた範囲でも、低デフォルト区分のPDがこうした外部情報との突き合わせなしに決まることはありませんでした。強さを変えて事後分布を比べます。
a0, b0 = 0.005 * m, 0.995 * m   # 平均0.5%、強さm社・年ぶん
a1, b1 = a0 + k, b0 + (n - k)   # ベイズ更新はこの1行
lo, hi = beta_dist.ppf([alpha / 2, 1 - alpha / 2], a1, b1)| 事前の強さ (社・年換算) | 事前分布 | 事後平均 | 事後95%区間 | 幅 |
|---|---|---|---|---|
| 200 | Beta(1, 199) | 0.48% | 0.26%〜0.78% | 0.52% |
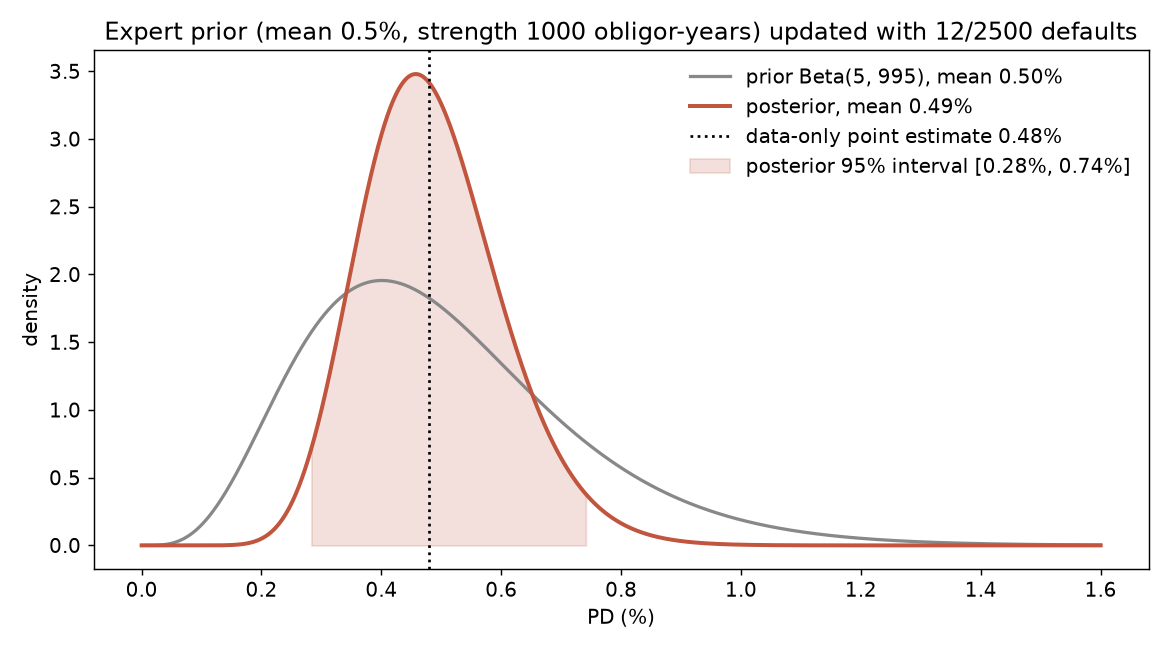
| 1,000 | Beta(5, 995) | 0.49% | 0.28%〜0.74% | 0.46% |
| 5,000 | Beta(25, 4975) | 0.49% | 0.35%〜0.66% | 0.32% |
実データが2,500社・年なので、強さ200はデータの1割足らずの重み、5,000はデータの2倍の重みにあたります。意見の平均0.5%が点推定0.48%とほぼ一致しているこの設定では、事前分布を強くしても事後平均はほとんど動かず、区間だけが0.52%から0.32%へ狭まります。強さ1,000の場合の事前分布と事後分布を重ねると、少数データが分布をどれだけ絞ったかが見えます。
意見が外れていた場合も確かめます。平均0.2%という誤った意見を強さ5,000で置くと、事後平均は0.29%、95%区間は0.18%〜0.43%となり、データだけの点推定0.48%を区間が含みません。強い事前分布は、間違っていればその間違いを引きずります。
それでもベイズ更新を勧めるのは、意見が「Beta(25, 4975)」という検証可能な形で残るからです。従来のやり方では、意見は担当者の頭の中の補正やスプレッドシートの手動調整として推定値に混ざり、後から分離できません。事前分布として書けば、「なぜ平均0.5%なのか」「5,000社・年ぶんも信じてよいのか」を検証部門や監査が個別に問えます。少数データの推定では、意見とデータの混ぜ方も、推定値と同じように検証の対象にできます。
推定誤差だけで必要資本の見積もりは2倍動く
最後に、この区間の幅を経営が読める単位に翻訳します。銀行の内部格付手法(IRB)では、PD・デフォルト時損失率(LGD)・エクスポージャー(EAD)を規制の式に入れて必要資本を計算します。バーゼルの企業向けリスクウェイト関数は、PDを入れると「EADの何%を資本として持つべきか」を返す式です。LGDは45%に固定し、マチュリティ調整は省いています。
def irb_capital(pd_, lgd=0.45):
    """バーゼルIRBの企業向けリスクウェイト関数(マチュリティ調整なし)"""
    pd_ = np.asarray(pd_, dtype=float)
    w = (1 - np.exp(-50 * pd_)) / (1 - np.exp(-50))
    R = 0.12 * w + 0.24 * (1 - w)   # PDに応じた資産相関
    K = lgd * (norm.cdf((norm.ppf(pd_) + np.sqrt(R) * norm.ppf(0.999))
                        / np.sqrt(1 - R)) - pd_)
    return K
区間の下端・点推定・上端をそれぞれ入れた結果です。
| 式に入れるPD | PDの値 | 必要資本K(EAD比) | EAD1,000億円あたり |
|---|---|---|---|
| Clopper-Pearson下端 | 0.25% | 2.76% | 28億円 |
| 点推定 | 0.48% | 4.08% | 41億円 |
| Clopper-Pearson上端 | 0.84% | 5.41% | 54億円 |
| 年ブロック上端 | 1.04% | 5.96% | 60億円 |
区間の上端の必要資本は下端の約2倍(1.96倍)です。EADが1,000億円の区分なら、統計的に同じ12件と整合するPDの範囲の中で、必要資本の見積もりが28億円から54億円まで、年の共変動まで考えれば60億円まで動きます。「どの区間のどの位置を使うか」という統計の議論が、そのまま数十億円の資本配賦の議論だと分かります。
期待損失に基づく貸倒引当も同じ構造を持ちます。期待損失はPD×LGD×EADにほぼ比例するため、PDが区間内で3.4倍動けば、引当の見積もりも同じ比率で変わります。規制資本の議論でも引当の議論でも、入り口にあるPDの推定誤差は同じです。
実務では、点推定をそのまま規制上のPDにせず、推定誤差ぶんの保守的なマージンを上乗せする運用が広く行われています。このマージンの大きさを「過去の慣行でこの程度」ではなく「95%区間の上側に相当する」と説明できると、モデル検証や当局との対話で根拠を問われたときの答えが具体的になります。区間の計算そのものは、scipyを呼ぶ数行で済みます。
まとめ
500社×5年・デフォルト12件の合成データで、点推定0.48%の裏にある幅を測りました。社・年の独立を仮定した正確な二項区間で0.25%〜0.84%、年の共変動を年ブロックブートストラップで反映すると0.12%〜1.04%まで広がり、必要資本の見積もりは区間の上下でおよそ2倍動きます。エキスパートの意見はBeta事前分布として混ぜれば、意見の強さが監査可能な形で残ります。
まず自社の対象区分で、デフォルト件数と社・年数を数えて、Clopper-Pearson区間を1回計算してみてください(scipyの beta.ppf を2回呼ぶだけです)。区間の幅が点推定と同じ桁なら、1つの数字だけで引当や必要資本を議論する段階ではありません。あわせて年ごとの件数を並べ、悪い年への固まりがあるなら、年単位の引き直しで区間がどこまで広がるかも確かめてください。