ポートフォリオのリスク管理:デフォルト相関が損失分布の裾を作る
はじめに
融資の審査は1社ずつ行います。決算書を読み、担保を確かめ、その1社が1年以内にデフォルト(債務不履行)する確率、つまりPD(Probability of Default、デフォルト確率)を見積もります。では、こうして審査した貸出先が1,000件集まったポートフォリオ全体では、1年にいくらまでの損失を覚悟すべきでしょうか。1件ずつの見積もりを合計すれば分かるでしょうか。
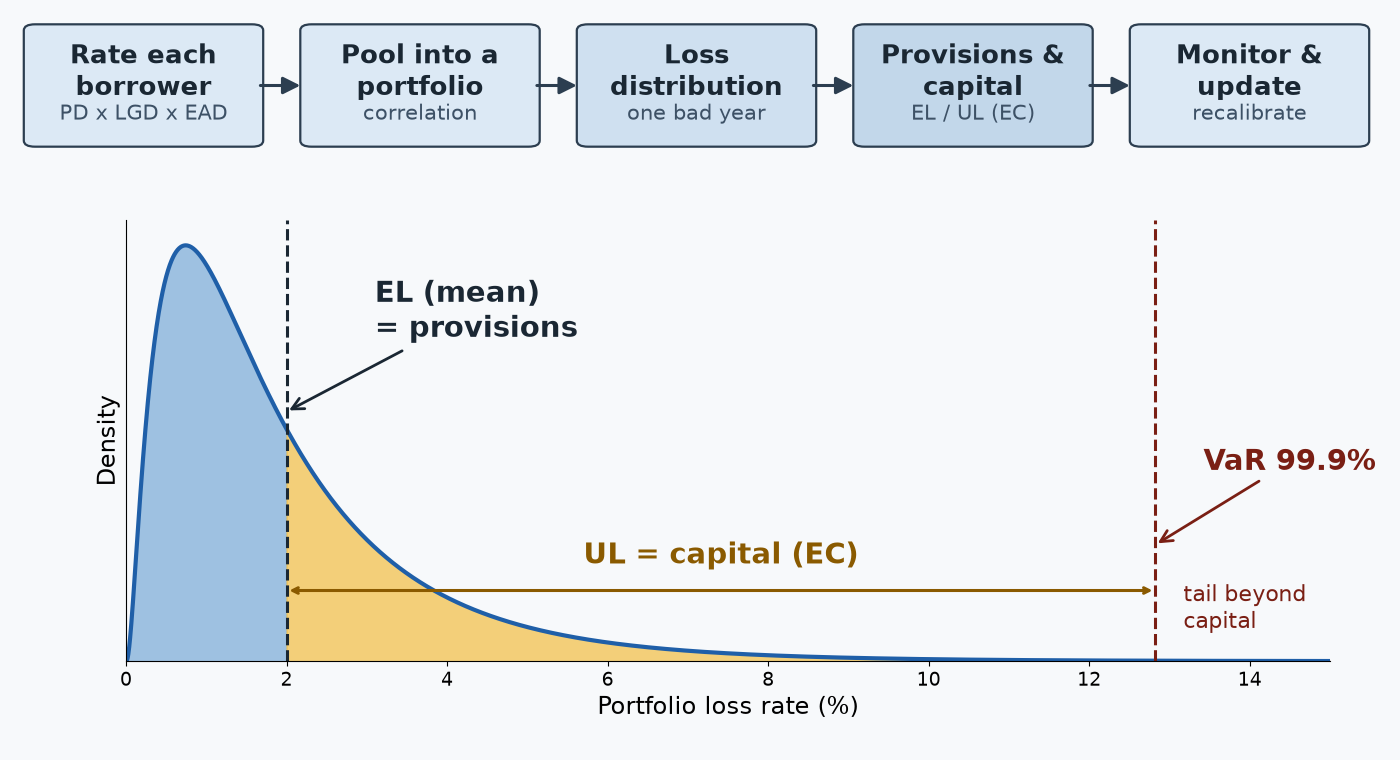
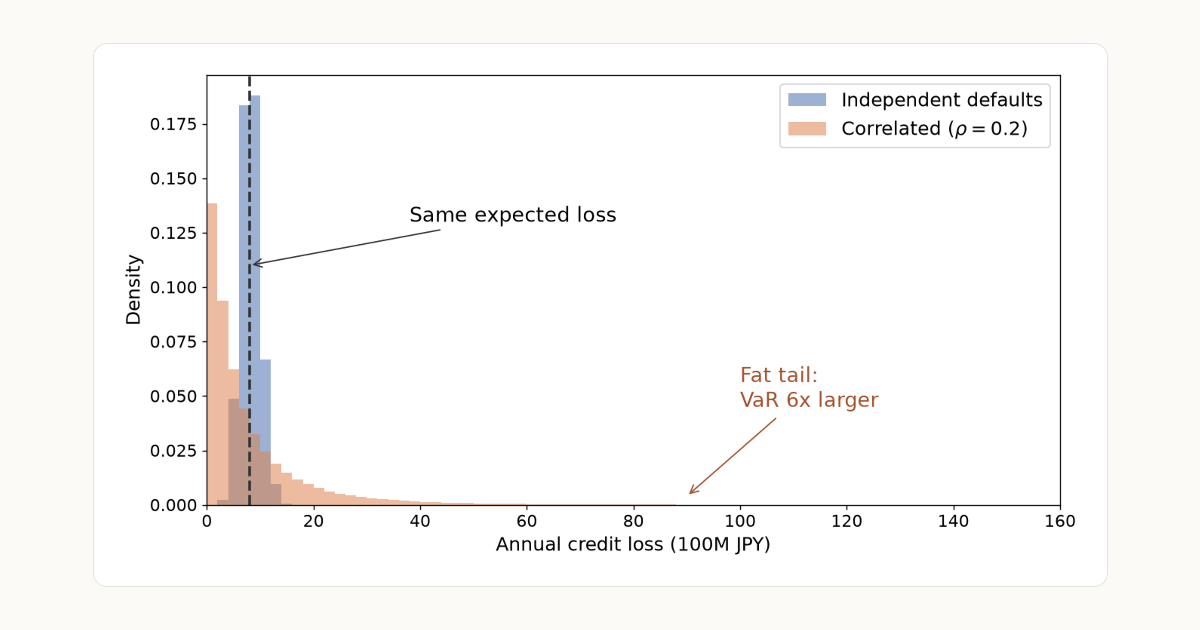
半分だけ分かります。1件ごとに見込まれる損失の平均(期待損失)は足し算できるので、ポートフォリオ全体の平均的な損失は合計で出せます。分からないのは残りの半分、景気の悪い年に損失がどこまで膨らむかです。貸出先はそれぞれ別の会社でも、同じ景気の下にいます。不況の年には多くの先の業績が同時に悪化するので、倒産は悪い年に集中します。この「同じ年に固まって倒れる」傾向の強さがデフォルト相関で、その強さしだいで、平均的な損失がまったく同じポートフォリオでも、悪い年に備えて持つべき経済資本(Economic Capital)は10倍以上違ってきます。
この記事では、貸出1,000件の合成ポートフォリオを100万年分モンテカルロでシミュレートし、相関の強さによって損失分布の裾、つまりめったに来ない悪い年の損失がどれだけ伸びるかを数値で確かめます。
対象読者:
- 与信ポートフォリオの管理・審査・リスク計測に関わる方
- 期待損失は計算しているが、経済資本やVaRとの関係を整理したい方
- 相関のあるイベントをモンテカルロでどう扱うかの実装例を探している方
記事のポイント:
- デフォルトが独立の場合と、1ファクターモデル(Vasicek型)で資産相関を入れた場合の損失分布を比較します
- 期待損失は相関に依存しない一方、99.9%VaRと経済資本は相関で数倍に伸びることをシミュレーションで確認します
- 期待損失は引当で、平均を超える損失は経済資本でカバーするという役割分担と、相関パラメータの実務上の扱いを整理します
期待損失の合計までは足し算で出せる
先に、貸出1件の条件を具体的に置きます。PD 2%、LGD(デフォルト時損失率。担保処分や回収を経てなお失う割合)40%、EAD(デフォルト時のエクスポージャー。要は貸出残高)1億円です。この貸出先が倒産すると、損失は1億円 × 40% = 4,000万円になります。起きる確率が2%なので、1年で見込む損失の期待値は4,000万円 × 2% = 80万円です。
これを1,000件並べたのが今回のポートフォリオです。全件同じ条件という設定は現実にはありえませんが、相関の効果だけを取り出して見るための単純化です。
期待損失(EL, Expected Loss)は期待値の足し算で、80万円 × 1,000件 = 8億円になります。この足し算は各社の倒産が独立かどうかに関係なく成り立ちます。期待値は線形なので、相関がどれだけ強くても合計の期待値は変わりません。1件ずつの期待損失を足し上げる計算で出せるのは、ここまでです。
もし倒産が互いに独立なら、話はここでほぼ終わりです。1年あたりのデフォルト件数は平均20件、標準偏差4.4件の二項分布に従い、大数の法則が働いて毎年の損失は8億円の近くに集まります。100万年シミュレートしても、99.9%点(1,000年に1回の規模)で35件、損失14億円にしかなりません。
この独立の仮定は、意識して選んだものとは限りません。スコアリングモデルが出すのは1社ごとのPDまでで、それをポートフォリオに束ねるときに「各社のデフォルトは互いに無関係」と暗黙に扱っていれば、明示的に置いた覚えがなくても独立を仮定したことになり、上の二項分布の細い損失分布がそのまま答えになります。
実際の与信ポートフォリオは、こう振る舞いません。貸出先の多くは同じ景気、同じ金利環境、しばしば同じ業種や地域に晒されています。製造業向けの貸出は海外需要の減速で同時に苦しくなり、不動産向けは金利上昇で同時に苦しくなります。貸出先同士に取引関係がなくても、同じマクロ環境の下にいるというだけで、倒産は同じ年に固まります。この「同じ年に固まる」性質を確率モデルに乗せたものがデフォルト相関です。
1ファクターモデルで景気による連動を表す
デフォルト相関を扱う定番が1ファクターモデル(Vasicek型)です。下敷きにあるのはMertonモデルの捉え方で、企業の資産価値が負債の水準を下回った時点でデフォルトする、と考えます。次の式は、その資産価値を標準化したうえで、全社共通の景気の寄与と、その会社固有の事情の寄与とに分解する装置です。
は 社の資産価値で、経営状態の良し悪しを標準化した値と読みます。 が全社に共通する景気ファクター、 が 社固有の要因で、どちらも標準正規分布に従う独立な乱数です。資産相関 は、資産価値の変動のうち景気で説明される割合を表します。 が閾値 を下回ると倒産と判定します。 も標準正規に従うので、倒産確率が2%になるように と置きます( は標準正規分布の分位点関数)。
記号だけでは動きが見えないので、1,000年に1度級の不況年(、 の下位0.1%点)を固定して、 のもとで2社を判定してみます。
個別要因が悪いA社()の資産価値は で、閾値 を下回り倒産します。同じA社を平時()に置くと資産価値は で、余裕を持って生き残ります。A社を倒したのは自社の事情だけではありません。平時なら耐えられた程度の不調が、景気の押し下げと重なって閾値を割りました。一方、個別要因が良いB社()は、この不況年でも資産価値 で生存します。
全社が同じ の下に置かれるこの年、1社あたりの倒産確率は2%から22.6%へ、平時の11倍に跳ね上がります。1,000件のうち226件前後が同じ年に倒れる計算になります。相関とはこの仕組みのことで、個社を見ているかぎり2%のままのPDが、景気を条件にすると年によってまったく別の値になります。
景気を固定すると件数は二項分布に従い、100万年分が数秒で計算できる
このモデルをNumPyでシミュレートします。素直に書くと1年あたり1,000社 × 100万年分の乱数が要りますが、1ファクターモデルには計算を軽くする性質があります。景気ファクター を固定すると各社の倒産は互いに独立になるので、均一ポートフォリオならその年のデフォルト件数を二項分布 から1回で引けます。1社ずつ乱数を引くのと同じ分布が得られ、100万年分が数秒で計算できます。
import numpy as np
from scipy.stats import norm

SEED = 42
N_FIRMS = 1000          # 貸出件数
PD = 0.02               # 1年デフォルト確率(全社均一)
LGD = 0.40              # デフォルト時損失率
EAD = 1.0               # 1件あたりエクスポージャー(億円)
LOSS_PER_DEFAULT = EAD * LGD  # 1件デフォルトあたりの損失 = 0.4億円
N_SIMS = 1_000_000      # シミュレーション年数

C = norm.ppf(PD)        # デフォルト閾値(企業価値がこれを割るとデフォルト)


def simulate_default_counts(rho, n_sims, seed):
    rng = np.random.default_rng(seed)
    if rho == 0.0:
        return rng.binomial(N_FIRMS, PD, size=n_sims)
    z = rng.standard_normal(n_sims)
    p_cond = norm.cdf((C - np.sqrt(rho) * z) / np.sqrt(1.0 - rho))
    return rng.binomial(N_FIRMS, p_cond)


def risk_measures(losses):
    el = losses.mean()
    ul = losses.std()
    var999 = np.quantile(losses, 0.999)
    ec = var999 - el
    return el, ul, var999, ec
p_cond が前の節で出した条件付き倒産確率 で、 を入れると0.226が返ります。乱数は np.random.default_rng(42) で固定し、同じシードで2回実行して件数配列が完全に一致することを確認済みです。独立ケースは に相当し、景気に関係なく を引きます。
相関を強めても期待損失は変わらず、VaRは数倍になる
独立の場合と、資産相関 を0.1 / 0.2 / 0.3と振った場合の4ケースで、それぞれ100万年分の損失分布を出しました。見る指標は4つです。ELは先ほどの期待損失、UL(Unexpected Loss)は平均を超える振れの大きさで、ここでは損失の標準偏差で測ります。VaR(Value at Risk)は99.9%点、つまり1,000年に1回の規模の年間損失です。経済資本(Economic Capital, EC)= VaR − EL は、期待を超える損失を吸収するために持つべき額の目安になります。
| ケース | EL | UL | VaR(99.9%) | EC = VaR − EL |
|---|---|---|---|---|
| 独立 | 8.0億円 | 1.8億円 | 14.0億円 | 6.0億円 |
| ρ = 0.1 | 8.0億円 | 7.0億円 | 52.4億円 | 44.4億円 |
| ρ = 0.2 | 8.0億円 | 10.8億円 | 91.2億円 | 83.2億円 |
| ρ = 0.3 | 8.0億円 | 14.4億円 | 134.4億円 | 126.4億円 |
ELの列は上から下まで8.0億円で並びます。期待値の線形性から当然の結果ですが、シミュレーションでも確かめられました。
動くのは残りの3列です。VaRは独立の14.0億円に対し、 で91.2億円と6.5倍、 で134.4億円と9.6倍になります。ECの倍率はさらに大きく、 で13.9倍、 で21.1倍です。平均で見るかぎり同一のポートフォリオが、備えるべき経済資本では桁が変わります。
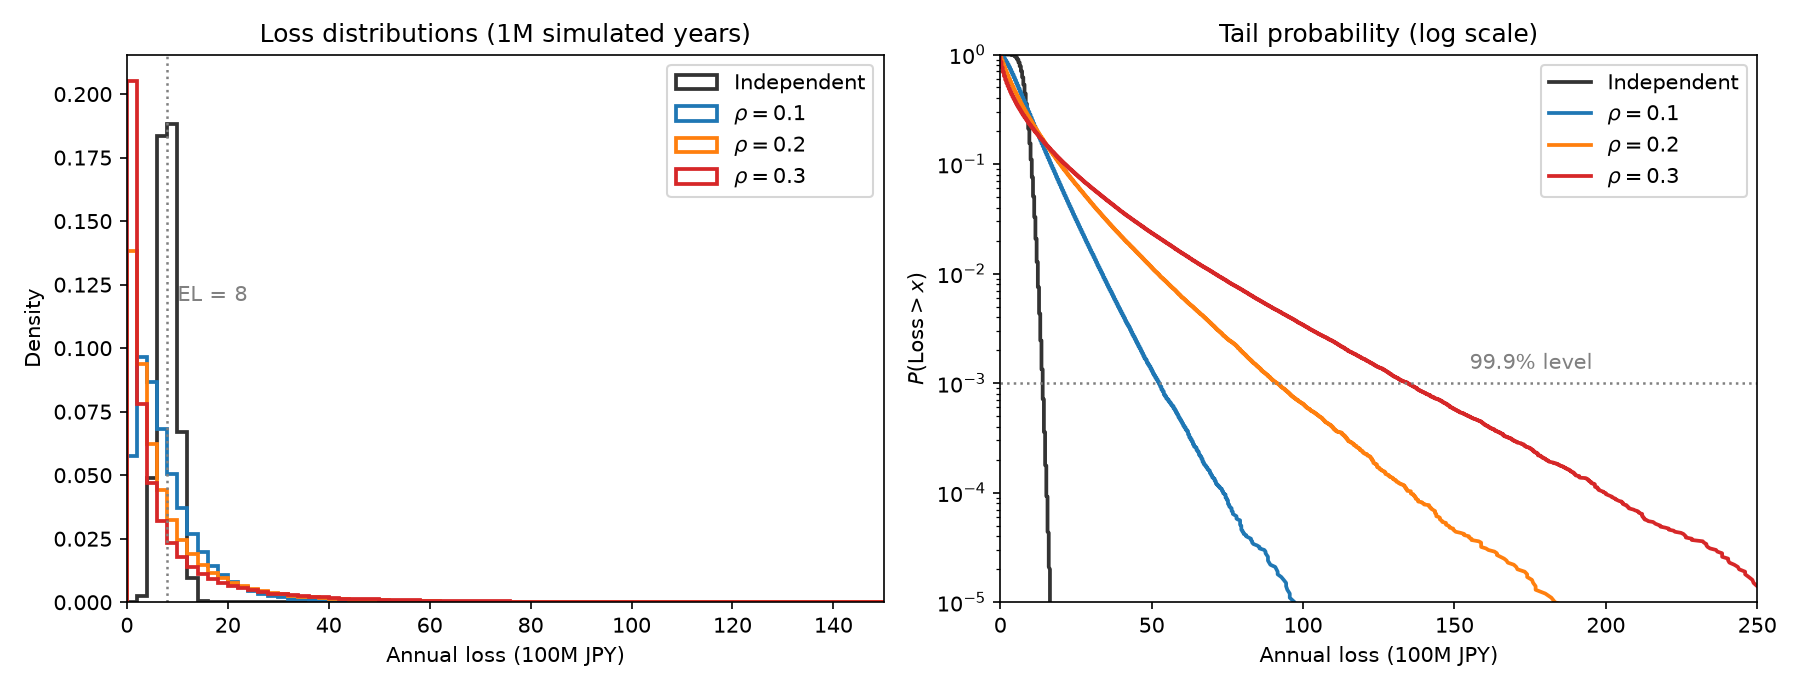
分布の形を見ると、何が起きたか分かります(上図左)。独立の分布は8億円を中心に細く尖り、ほぼ左右対称です。相関を入れると山はむしろ左へ寄り、最頻値はELより小さくなります。そのぶん右へ長い裾を引きます。多くの年は平均より軽い損失で済み、まれに来る大きな損失の年が平均を引き上げる、という歪んだ形です。
上図右は縦軸を対数にした裾確率 で、独立の線が損失20億円あたりで垂直に落ちるのに対し、相関ありの線は緩やかに減衰しながら遠くまで届きます。99.9%の水平線との交点が各ケースのVaRです。
を細かく振ると、ELとの対比がさらにはっきりします。
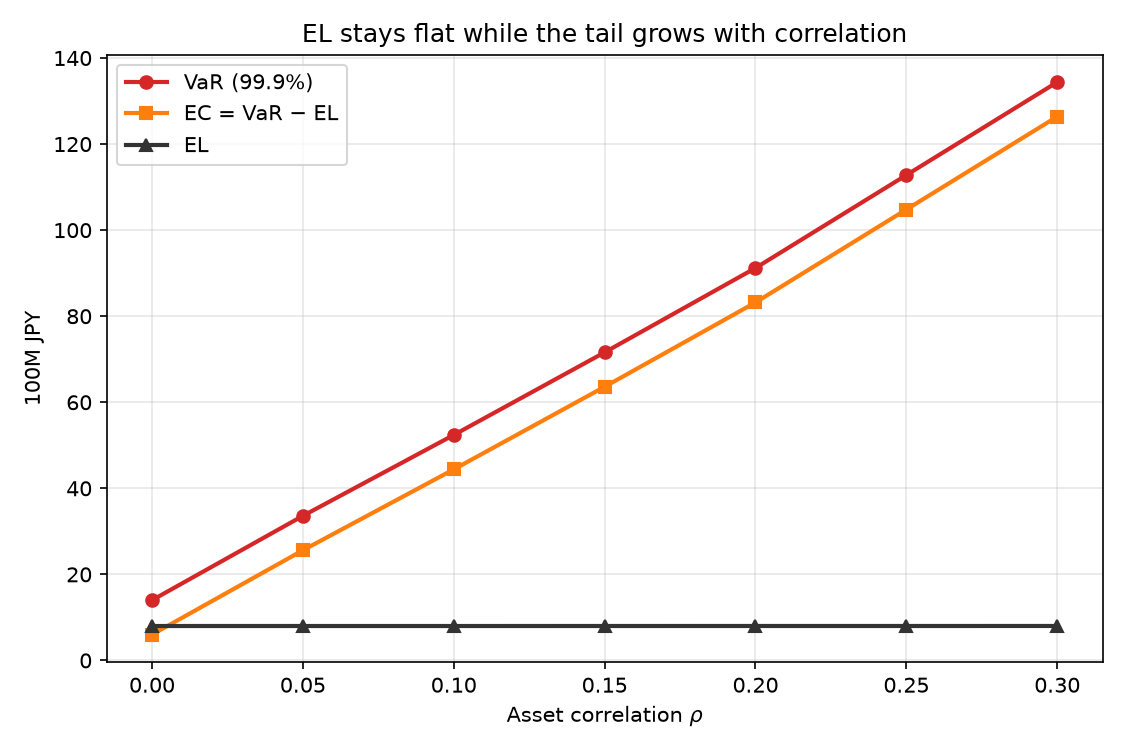
ELの線は にまったく反応せず水平のままです。VaRとECは から0.3までの範囲でほぼ直線的に増え、0.05刻みごとにおよそ20億円ずつ積み上がります。相関パラメータの想定が0.1ずれるだけで、経済資本の見積もりが40億円規模で動くということです。
この裾は、貸出件数を増やしても消えません。独立なら件数を10倍にすると損失率のばらつきは 分の1に縮み、分散投資がそのまま安全につながります。相関がある場合、個別要因 のばらつきは同じ理屈で縮みますが、全件に共通する のばらつきは1件増やしても1万件増やしても減りません。件数を無限に増やした極限では、その年の損失率は条件付き倒産確率 そのものに張り付き、分布の形は の分布だけで決まります。裾を作っているのが分散不可能な共通ファクターである以上、対策は件数の積み増しには求められず、経済資本の手当てか、業種・地域をまたいだ構成の分散になります。
相関が強いほど平時は健全に見え、倒産は不況の年に集中する
集計値だけでは1年の姿が想像しにくいので、景気シナリオごとの期待デフォルト件数(1,000件中)に翻訳します。各行は景気ファクター の水準を固定したときの条件付き期待値で、独立の列だけは景気の定義がないため常に平均の20件です。
| 景気シナリオ | Z | 独立 | ρ = 0.1 | ρ = 0.2 | ρ = 0.3 |
|---|---|---|---|---|---|
| 普通の年(中央値) | 0.00 | 20件 | 15件 | 11件 | 7件 |
| 10年に1度の不況(下位10%) | −1.28 | 20件 | 41件 | 49件 | 53件 |
| 100年に1度の不況(下位1%) | −2.33 | 20件 | 82件 | 129件 | 176件 |
| 1,000年に1度の不況(下位0.1%) | −3.09 | 20件 | 128件 | 226件 | 333件 |
まず目を引くのは、普通の年の行です。 なら11件と、独立の20件より少なくなります。相関が変えるのはリスクの現れ方です。平穏な年からデフォルトを取り除き、まれな不況年へ集中させるので、日常の実績だけを眺めていると相関の強いポートフォリオのほうがむしろ健全に見えます。この見かけの健全さが、平時に相関を過小評価しやすい理由のひとつです。
不況の行では大小が入れ替わります。10年に1度、つまりキャリアの中で何度か遭遇する程度の不況でも、 で49件と平時の2倍を超えます。100年に1度の不況では129件、平時の10倍を超える倒産が1年に集中します。1,000年に1度なら226件、 に至っては333件、3社に1社が同じ年に倒れます。前の節のVaR 91.2億円という数字は、この226件前後の年の損失(件数 × 4,000万円で約90億円)に対応します。A社のように「平時なら耐えられた会社」が景気の押し下げで閾値を割る事象が、1,000件の中で数百件同時に起きた年です。
期待損失は引当で、平均を超える損失は経済資本でカバーする
この計算は何のためにやるのか。与信の損失への備えは二層に分かれていて、担当が違います。ELは「毎年ほぼ確実に出る費用」なので、貸出金利への上乗せと貸倒引当金で賄います。1件あたり80万円の期待損失は、金利に織り込んでおけば長期的には収支が合います。
一方、裾の損失は出るかどうか分からないうえ、出た年には引当をはるかに超えます。これを吸収するのが自己資本で、いくら用意しておくべきかの目安が経済資本 EC = VaR − EL です。どちらの備えをどの数字で見積もるかという分担の全体像は、信用リスク管理の全体像で整理しています。
この分担を今回の数字に当てはめると、相関の想定は引当にはまったく影響せず、経済資本にだけ数倍単位で影響することが分かります。バーゼル規制の内部格付手法(IRB)が所要資本の算式に採用しているのも、今回とまったく同じ1ファクターモデルの考え方で、規制上の資産相関は資産クラスに応じて0.12から0.24の範囲などと定められています。今回の実験で を0.1から0.3まで振ったのは、およそこの規制レンジをなぞっています。その範囲の中だけでECが3倍近く動くわけです。
では、自分のポートフォリオの はいくつなのか。当たりをつける最短の方法は、年次デフォルト率のばらつきから逆算することです。もし倒産が独立なら、1,000件でのデフォルト率の標準偏差は0.44%ポイントにしかなりません(二項分布から直接出ます)。実績のデフォルト率が平均2%を中心に標準偏差1.8%ポイントで振れているなら、それは独立ではまったく説明できない振れ幅で、今回のシミュレーションの にほぼ一致します。同様に2.7%ポイントなら 、3.6%ポイントなら に対応します(表のULを1,000件 × 0.4億円で割ると、この換算が出ます)。
ただし、この逆算がそのまま使えるほど実務は甘くありません。信用リスクモデリングで最も悩ましいのは、 が結果に最も大きく響くパラメータでありながら、最も検証しにくいパラメータでもあることです。PDなら毎年のデフォルト実績と突き合わせて較正できます。ところが相関は「景気の底でどれだけ同時に倒れたか」という形でしか観測に現れず、手元の実績データに深刻な不況は1〜2回しか含まれていないのが普通です。
数点の観測から裾を決めるパラメータを推定することになるので、点推定を過信せず、規制値や外部データと突き合わせたうえで を振った感応度を必ず添える、というのが私の進め方です。前の節で に対するVaRの推移を描いた図がまさにその感応度分析で、経営に見せるべきは「VaRは91億円です」という1点ではなく、「相関の見立て次第で52億円から134億円まで動きます」という幅です。
最後に、今回の単純化が何を落としているかを挙げます。全件均一という設定を外して業種や格付ごとの構成にしても、話の骨格は変わりませんが、大口先への集中があると裾はさらに厚くなります。また、正規分布のファクターは裾での連動が弱めに出ることが知られており、tコピュラなど裾依存の強い構造に替えると同じ でもVaRは大きくなります。分布の裾を本体とは別に扱うべきだという論点は、極値統計によるテールリスク評価で別の角度から扱っています。いずれの精緻化も裾を厚くする方向に働くので、独立で見積もった経済資本は下限であり、実際にはそれより多く要ると考えるのが安全です。
コード
実験に使ったスクリプトの本体です。同じシードで2回実行し、結果が完全に一致することを確認しています。
"""デフォルト相関が損失分布の裾に与える影響を1ファクターモデル(Vasicek型)で測る。

合成ポートフォリオ: 貸出1,000件、PD 2%、LGD 40%、EAD 1億円で均一。
比較: (a) デフォルト独立 vs (b) 1ファクターモデルで資産相関 rho = 0.1 / 0.2 / 0.3。
各ケースで EL・UL(標準偏差)・VaR(99.9%)・EC = VaR - EL を出す。
"""

import numpy as np
from scipy.stats import norm

SEED = 42
N_FIRMS = 1000          # 貸出件数
PD = 0.02               # 1年デフォルト確率(全社均一)
LGD = 0.40              # デフォルト時損失率
EAD = 1.0               # 1件あたりエクスポージャー(億円)
LOSS_PER_DEFAULT = EAD * LGD  # 1件デフォルトあたりの損失 = 0.4億円
N_SIMS = 1_000_000      # シミュレーション年数

C = norm.ppf(PD)        # デフォルト閾値(企業価値がこれを割るとデフォルト)


def simulate_default_counts(rho, n_sims, seed):
    """1年ごとのデフォルト件数を n_sims 年分シミュレートする。

    rho=0 は独立ケース(Binomial(N, PD) を直接引く)。
    rho>0 は1ファクターモデル: 企業iの資産価値
        A_i = sqrt(rho) * Z + sqrt(1-rho) * eps_i
    が閾値 C を割るとデフォルト。Z を固定すれば各社は条件付き独立なので、
    件数は Binomial(N, p(Z)) に従う。
    """
    rng = np.random.default_rng(seed)
    if rho == 0.0:
        return rng.binomial(N_FIRMS, PD, size=n_sims)
    z = rng.standard_normal(n_sims)
    p_cond = norm.cdf((C - np.sqrt(rho) * z) / np.sqrt(1.0 - rho))
    return rng.binomial(N_FIRMS, p_cond)


def risk_measures(losses):
    el = losses.mean()
    ul = losses.std()
    var999 = np.quantile(losses, 0.999)
    ec = var999 - el
    return el, ul, var999, ec


def conditional_pd(rho, z):
    """共通ファクターが z のときの条件付きデフォルト確率 p(z)。"""
    return norm.cdf((C - np.sqrt(rho) * z) / np.sqrt(1.0 - rho))


def main():
    # 再現性チェック: 同じシードで2回引いて一致を確認
    a = simulate_default_counts(0.2, 10_000, SEED)
    b = simulate_default_counts(0.2, 10_000, SEED)
    assert np.array_equal(a, b), "同一シードで結果が一致しない"

    # ケース別のリスク指標
    rhos = [0.0, 0.1, 0.2, 0.3]
    print(f"{'ケース':<12}{'EL':>8}{'UL':>8}{'VaR99.9%':>10}{'EC':>8}")
    for rho in rhos:
        counts = simulate_default_counts(rho, N_SIMS, SEED)
        losses = counts * LOSS_PER_DEFAULT
        el, ul, var999, ec = risk_measures(losses)
        label = "独立" if rho == 0.0 else f"rho={rho}"
        print(f"{label:<12}{el:>8.2f}{ul:>8.2f}{var999:>10.1f}{ec:>8.1f}")

    # 景気シナリオ別の期待デフォルト件数(1,000件中)
    scenarios = [("普通の年", 0.5), ("10年に1度", 0.10),
                 ("100年に1度", 0.01), ("1000年に1度", 0.001)]
    for name, q in scenarios:
        z = norm.ppf(q)
        row = f"{name:<12}Z={z:>6.2f}  独立: {N_FIRMS * PD:>4.0f}件"
        for rho in [0.1, 0.2, 0.3]:
            row += f"  rho={rho}: {N_FIRMS * conditional_pd(rho, z):>4.0f}件"
        print(row)


if __name__ == "__main__":
    main()
まとめ
期待損失8億円という数字は、倒産が独立でも相関していても変わりません。変わるのはその先で、資産相関0.2を入れると99.9%VaRは14億円から91億円へ6.5倍に、経済資本は6億円から83億円へ14倍近くに増えました。1社ずつの審査精度をいくら磨いても、この差は縮まりません。差を生んでいるのは貸出先が同じ景気に晒されているという構造で、個社の審査では触れられない場所にあるからです。しかも相関の強いポートフォリオは、平時のデフォルト実績がむしろ少なく見えるため、日常の数字からは危うさが読み取れません。
手元のポートフォリオで独立を仮定した損失見積もりを使っている箇所があれば、まず業種・地域の構成から相関の見当をつけ、今回のスクリプトのように を振ったときのVaRの幅を出してみてください。その幅がいま持っている自己資本に収まるかどうかが、相関の見立てをこのまま放置してよいかの判断材料になります。