ゼロゼロ融資の時期の延滞データで、融資先の悪化を予測するモデルを学習してよいか
はじめに
入出金データで融資先の悪化を早めに見つけるモデルを作ろうとして、過去の延滞実績を年ごとに数えると、2020年から2022年だけ件数がはっきり減っています。景気が良かった年ではありません。飲食や宿泊の売上が大きく落ちた年に、延滞は逆に少なかったことになります。
理由ははっきりしています。実質無利子・無担保の融資(いわゆるゼロゼロ融資)と返済猶予で、資金繰りの悪化が延滞として表に出る前に手当てされていたからです。この期間のデータをそのまま学習に入れると、モデルは「入金が大きく減っても延滞しない」という関係を学びます。この3年間は、延滞だけをラベルにして使うのをやめ、条件変更と債務者区分の引き下げまでラベルを広げて使うか、それが無理なら学習から外し、評価は期間を分けて報告するのがよいと考えています。
以下では、架空の融資先1社がどんなラベルで学習データに入るかを確かめ、公開統計で期間の特徴を押さえたうえで、4つの扱い方を比べます。
対象読者:
- 地域金融機関の融資部・審査部・リスク管理部で、融資先の期中モニタリングや予兆管理の仕組みを検討している方
- 延滞・倒産の予兆検知モデルを開発・検証していて、2020〜2022年のデータの扱いに迷っている方
- 予兆検知モデルの導入を判断する立場で、ベンダーの検証結果のどこを確かめればよいか知りたい方
記事のポイント:
- 支援策のあった期間は、悪化した融資先の多くに延滞のラベルが付いておらず、学習・検証・「何か月前に気づけたか」の計測のそれぞれをゆがめます
- 期間の除外、期間フラグ、ラベル定義の拡張、期間別の評価の4案を、失うデータ量と、返済開始後の延滞の出方をどれだけ反映できるかで比べます
- 合成データでは、全体の捕捉率の差は1〜2ポイントにとどまる一方、支援を受けた融資先に絞ると扱い方で最大10ポイント差が出ました
入金が4割減った飲食業者は、学習データに6回「延滞なし」として入る
ある地方都市で居酒屋を2店舗営む会社を考えます(架空の例です)。2019年の年商は約7,800万円、口座への売上入金は月650万円前後で、預金残高はおおむね月商1か月分でした。
2020年4月以降、入金は月390万円前後まで落ちます。前年比で4割減です。この会社は2020年6月に民間金融機関から実質無利子・無担保の融資を3,000万円借り、据置期間3年、その後10年で返済する条件にしました。預金残高は一時3,300万円まで増え、落ち込んだ月商で割ると8か月分を超えます。
2021年2月には、以前からのプロパー融資(信用保証の付かない融資)の元金返済を1年猶予する条件変更にも応じてもらいました。延滞は一度も起きていません。
据置期間が終わった2023年7月から、月25万円の元金返済が始まります。入金は2019年の水準に戻りきらず、借りた資金で積み上がった預金は取り崩されていきます。2024年3月に約定返済が1か月遅れ、これが最初の延滞になりました。
この会社を予兆検知モデルの学習データに入れると、次のようになります。観測時点を半年ごとに置き、その時点から12か月以内に1か月以上の延滞が起きたら1、起きなければ0をラベルとする、よくある作り方です。
| 観測時点 | 月の入金(2019年比) | 入金の前年同月比 | 預金残高(月商倍率) | ラベル(12か月以内の延滞) |
|---|---|---|---|---|
| 2019年7月 | 650万円(0%) | +2% | 1.0か月 | 0 |
| 2020年7月 | 390万円(−40%) | −40% | 8.5か月 | 0 |
| 2021年7月 | 370万円(−43%) | −5% | 7.8か月 | 0 |
| 2022年7月 | 450万円(−31%) | +22% | 5.1か月 | 0 |
| 2023年7月 | 500万円(−23%) | +11% | 2.6か月 | 1 |
| 2024年1月 | 480万円(−26%) | −4% | 1.7か月 | 1 |
表には年1回の時点だけを載せていますが、半年ごとに数えると2020年7月から2023年1月までの6時点がすべて0です。入金が4割減り、条件変更にも応じてもらった会社が、学習データでは6回「延滞しなかった例」として数えられます。しかもその6回のうち多くは、預金残高が厚い状態で記録されています。
ラベルが1になるのは2023年7月以降の2時点だけで、そのときの入金の前年同月比は+11%と−4%です。前年同月比だけを見ると、この会社は回復途上に見えます。比較の基準になる前年がすでに落ち込んでいるからです。悪化が始まったのは2020年4月で、延滞が起きたのは約4年後の2024年3月でした。12か月以内の延滞をラベルにする限り、この4年のうち最初の3年分の観測は、悪化の兆候として学習されません。
公開統計でも、倒産は2021年に底を打ち、返済が始まると1万件を超えた
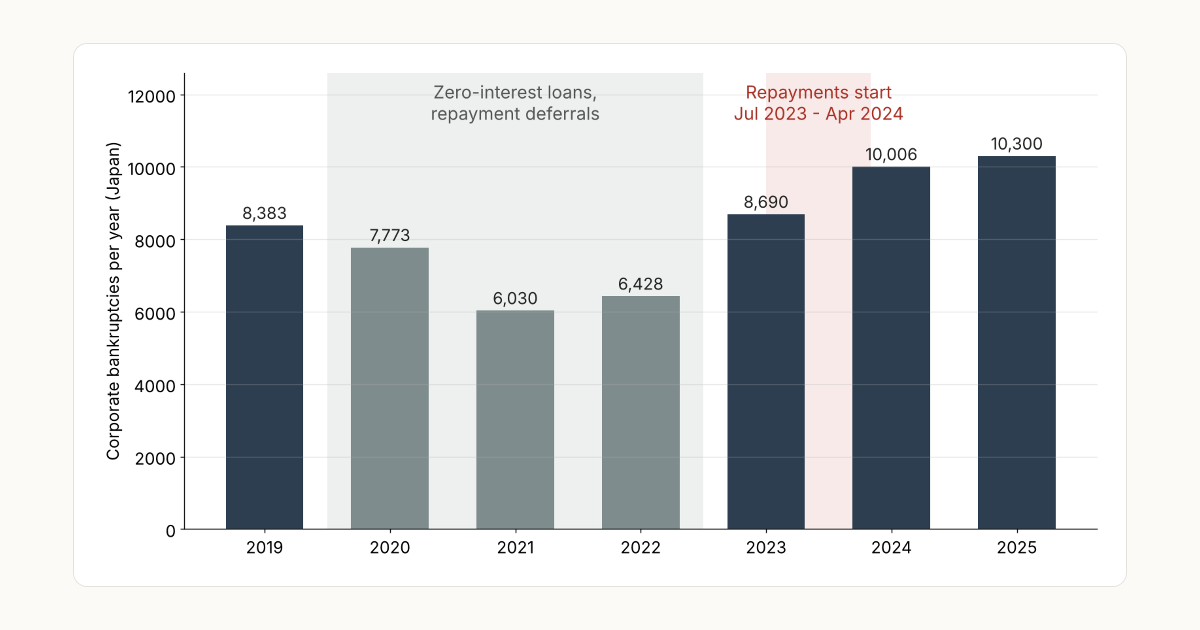
この会社の経過は、全国の数字とも合っています。東京商工リサーチの集計(負債1,000万円以上)では、全国の企業倒産は2019年の8,383件から、2020年7,773件、2021年6,030件と減りました。2021年の件数は1964年以来57年ぶりの低水準です。その後は2022年6,428件、2023年8,690件と増え、2024年は10,006件で11年ぶりに1万件を超え、2025年も10,300件でした。
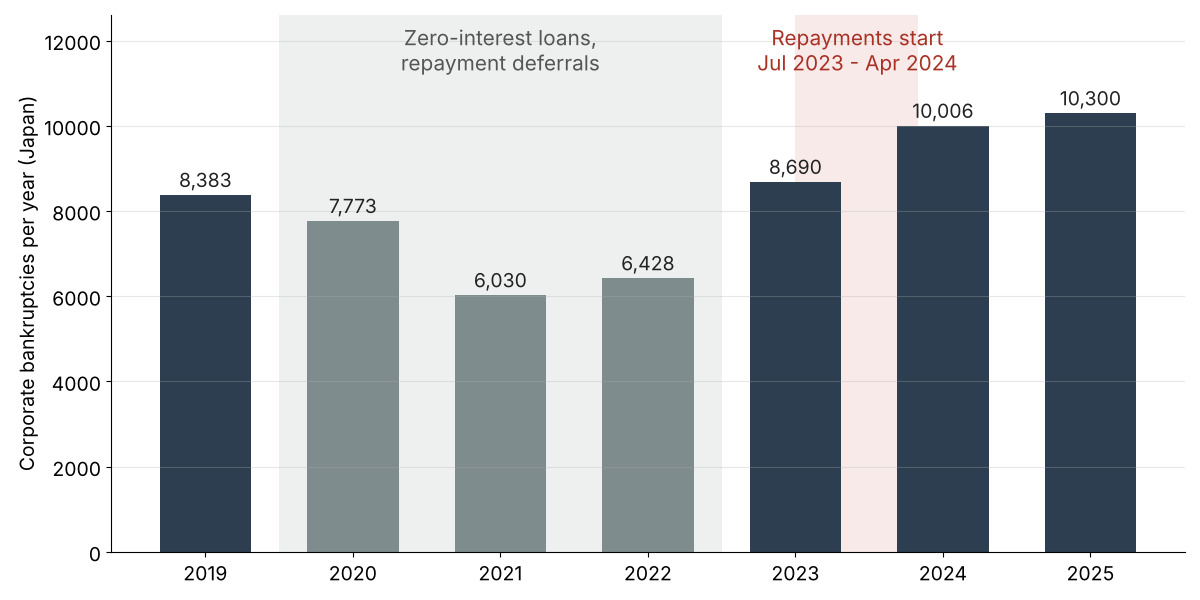
件数を押し下げた支援策は、規模が大きく、期間も長く続きました。
- 2020年3月6日、金融庁は預金取扱金融機関に対し、既往債務の元本・金利を含めた返済猶予などの条件変更に迅速かつ柔軟に対応するよう要請しました
- 民間金融機関による実質無利子・無担保融資は2021年3月末に申込期限を迎え、政府系金融機関の分と合わせた承諾実績は2022年10月末までに約247万件、約43兆円に達しました(中小企業庁の資料による。うち民間分が約137万件・約23兆円)
- 2021年3月8日の金融庁の要請文は、条件変更や新規融資を行う場合の債権の区分について、感染拡大前に正常先と認識していた事業者を感染拡大前と同一の評価とすることも含め、金融機関の判断を尊重するとしています
- 中小企業庁の資料では、民間ゼロゼロ融資の返済開始時期は2023年7月から2024年4月に集中する見通しでした
3つ目の点は、ラベルを設計するうえで見落とせません。延滞だけでなく、債務者区分(金融機関が自己査定で融資先を正常先・要注意先・破綻懸念先などに分ける区分)の引き下げも、この期間は抑えられていた可能性があります。延滞の代わりに区分の変化をラベルにすれば済む、とは言い切れません。
また、日本政策金融公庫(国民生活事業)が2021年3月までにコロナ関連の融資をした約70万先について、2022年9月末時点で条件変更をしていた先は約3.2万件(4.5%)、据置期間中が約11万件(15.2%)でした。2022年秋の時点でも、据置期間中か条件変更中で通常の元金返済に入っていない先が約2割あったことになります。
ラベルが付かなかった3年間は、学習・検証・リードタイムの計測をそれぞれゆがめる
ゆがみの出方は、データを学習に使うか、検証に使うか、「何か月前に気づけたか」の計測に使うかで違います。
学習に使う場合、モデルは入金の落ち込みと延滞の関係を弱く見積もります。入金が大きく減った先ほど支援を受け、支援を受けた先ほど延滞が出なかったからです。加えて、借入で厚くなった預金残高は、データの上では「残高が厚い先は延滞しない」という関係として学ばれます。支援が終わって返済が始まると、この2つはどちらも成り立ちません。入金が減ったままの先は延滞し、預金残高の厚みは返済で消えていきます。
検証に使う場合は、的中率(要確認先として挙げた先のうち、実際に延滞した先の割合)が低く出ます。モデルが入金の落ち込みを見て正しく要確認先に挙げても、支援で延滞が出なかった先は、検証では空振りとして数えられるからです。捕捉率(実際に延滞した先のうち、事前に要確認先に挙がっていた割合)も、分母の延滞先が支援を受けなかった先に偏るため、モデルの実力とは別のものを測ることになります。
リードタイムについては、前の節の会社がそのまま例になります。悪化の開始から延滞までが約4年に延びたため、12か月以内の延滞で作ったラベルでは、悪化の初期の観測が0のままになります。延滞直前の観測だけが1になります。
検証で「延滞の何か月前に要確認先に挙がったか」を測ると、入金の前年同月比を主な指標にしたモデルでは、2023年以降の延滞先のリードタイムが短く出ます。延滞の直前まで、入金が回復しているように見えるからです。観測時点をそろえないとリードタイムが長く出るという逆向きの問題もあり、こちらは検証の時点のそろえ方として別に整理しています。
4つの扱い方は、データ量と直近の延滞の出方のどちらを優先するかで分かれる
実務で検討にのぼる扱い方を、表にまとめます。
| 扱い方 | やること | 得るもの | 失うもの |
|---|---|---|---|
| 期間を除外する | 2020〜2022年の観測を学習から外す | 平常時の入金と延滞の関係がそのまま残る | 3年分のデータ。支援を受けた先の支援期間中の観測 |
| 期間フラグを入れる | 支援期間であることを示す変数を足す | データ量 | 主効果だけでは入金減と延滞の関係の強さのずれを直せない |
| ラベル定義を広げる | 延滞に加え、条件変更と債務者区分の引き下げも1にする | データ量と、支援期間の悪化先 | ラベルが金融機関の方針や区分の運用に左右される |
| 期間別に評価する | 検証結果を支援前・支援期・支援後に分けて報告する | どの期間の数字かが読める | 学習のゆがみ自体は直らない(他の3つと併用する) |
期間を除外するのが、最も分かりやすい対処です。2016〜2019年と2023年以降の観測だけで学習すれば、延滞が表に出なかった期間のラベルは含まれません。ただし、3年分を外すと学習に使える延滞例がそのぶん減り、もともと延滞例の少ない金融機関ほどその痛手は大きくなります。支援を受けた先が返済開始後にどう悪化するかという、いま最も知りたい点も、支援期間の観測を外すと学べません。
期間フラグは、データを捨てずに済むので魅力的に見えます。しかし、フラグを1本足しただけのモデル(フラグの主効果のみを入れたモデル)が補正できるのは「この期間は全体に延滞が少ない」という水準の差です。ゆがんでいるのは「入金が落ちた先ほど延滞が抑えられた」という、指標と延滞の関係の強さのほうです。フラグと各指標の掛け合わせ(交互作用)まで入れれば関係の強さの違いも吸収できますが、それは支援期間に別のモデルを当てるのとほぼ同じで、除外したときと結果が近くなります。
ラベル定義を広げる案は、欠けたラベルを補う方法に見えますが、実際には予測する対象を変える設計判断です。延滞だけをラベルにしたモデルは「延滞するか」を当てるモデルで、条件変更と区分の引き下げまで含めたモデルは「信用状態が悪化するか」を当てるモデルになります。要確認先の一覧に載る先も、担当者に求める確認の中身も変わるので、融資部とリスク管理部で目的に合うかを決めてから採ります。
この案は、支援期間の悪化先を学習に含められるのが強みです。前の節の会社なら、2021年2月の条件変更で、2020年7月の観測(延滞を見る12か月が2021年7月まで)が1になります。代わりに、ラベルが金融機関の方針の影響を受けます。
このとき区別が要るのは、業況の悪化を受けて個別に応じた条件変更と、支援策として申し出のあった先に一律に応じた条件変更です。後者まで1にすると、念のために条件変更に応じた健全な先も1になります。条件変更の記録に、申し出の理由や支援策の区分が残っているかを先に確かめます。
区分の引き下げは逆に、先に見た金融庁の方針もあって抑えられていた可能性があります。条件変更の日付や区分の履歴を観測時点ごとに引き出せるかどうかも、システムによって違います。
期間別の評価は、どの案を選んでも省けません。支援期の観測を検証に含めた数字と含めない数字は、意味が違います。1本の捕捉率にまとめて報告すると、読み手はどちらの数字なのか判断できません。
扱い方の差は、全体の捕捉率ではなく支援を受けた先の捕捉率に表れた
4案の違いがどこに現れるかを、合成データで確かめました。設定は次のとおりです。融資先4,000社について2016〜2024年に半年ごとの観測を作り、指標は入金の前年同月比、預金残高の月商倍率、借入依存度の3つです。
3割の先を対面型の業種とし、2020〜2022年はその入金を15〜50%落とします。対面型の先の85%が支援を受け、支援先で起きた悪化の85%は延滞として記録されず、そのうち6割が条件変更として記録されます。支援で増えた預金は借入なので、真のリスクは増える前の残高で決まるようにしました。2023年以降も対面型の先の入金は戻りきらず、借りた資金の一部が預金に残ります。
2016〜2022年の観測で学習し、2023〜2024年の観測で評価します。モデルはロジスティック回帰(指標の重み付きの和から延滞の確率を出す、標準的な統計モデル)で、スコアの上位10%を要確認先とし、延滞先のうち何割がそこに入ったか(捕捉率)を測りました。数値は乱数を変えた20回の平均です。
| 学習の仕方 | 全体の捕捉率 | 支援を受けた先の捕捉率 | 支援先の予測延滞率(実績4.0%) |
|---|---|---|---|
| そのまま学習 | 50.8% | 47.0% | 2.2% |
| 支援期間を除外 | 52.2% | 52.9% | 3.0% |
| 期間フラグ(主効果のみ) | 51.0% | 47.8% | 2.4% |
| 期間フラグ(指標との交互作用まで) | 52.2% | 52.6% | 2.9% |
| ラベルを延滞+条件変更に拡張 | 52.3% | 57.0% | 3.8% |
| 参考:支援がなかった場合の悪化で学習 | 52.6% | 56.1% | 3.6% |
全体の捕捉率では、どの学習の仕方でも差は1〜2ポイントで、乱数による振れ(そのまま学習した場合で46〜55%)に埋もれます。全体の数字だけを報告すると、この期間の扱いは結果に影響しないように見えます。
支援を受けた先に絞ると差が開きます。そのまま学習したモデルは、支援を受けた延滞先の47%しか要確認先に挙げられず、除外した場合より6ポイント低くなりました。20回すべてで除外が上回り、差は3〜10ポイントでした。
支援を受けた先の予測延滞率は、実際の延滞率4.0%に対して2.2%で、支援を受けた先のリスクを半分近く低く見積もっています。期間フラグを主効果だけで入れても、そのまま学習した場合とほとんど変わりません。交互作用まで入れると、前の節で述べたとおり除外とほぼ同じ結果になりました。
ラベルを延滞+条件変更に広げたモデルは、支援を受けた先の捕捉率が57.0%で、除外より4ポイント高く、20回すべてで上回りました。支援期間の悪化先を学習に含めつつ、データ量も減らさなかったためです。健全な先の条件変更(ここでは支援先の3%)がラベルに混ざっても、この設定ではその悪影響は、悪化先を学習に使える利点より小さく出ています。
もう1つ確かめたのが検証期間の置き方です。支援期間を除外して学習したモデルを、2020〜2022年の観測で検証すると、記録上の延滞で測った的中率は12.3%でした。記録されなかった悪化まで含めて測ると22.7%なので、要確認先に挙げた先のおよそ半分は、実際には悪化していたのに空振りとして数えられています。同じモデルを2023〜2024年で検証すると、記録上の延滞で測っても、記録されなかった悪化を含めても16.4%で一致します。支援期の観測で検証した的中率を導入判断に使うと、モデルの実力を半分近く低く評価することになります。
この実験の数字は設定に依存します。抑制の強さ(85%)や条件変更として記録される割合(6割)を変えれば、差の大きさも変わります。確かめたかったのは差の向きと現れる場所で、扱い方の違いは全体の捕捉率にはほとんど出ず、支援を受けた先と、予測延滞率の水準に出ます。
要確認先を「上位10%」ではなく、支援前の観測で決めたスコアの閾値で選ぶ運用だと、この水準のずれは一覧の件数に直接出ます。今回の設定では、閾値を固定したとき要確認先の割合はそのまま学習で9.8%、ラベル拡張で12.6%になりました。担当者が確認できる件数から閾値を決めている場合、学習の仕方を変えると一覧の件数も変わるので、確認可能件数との突き合わせをやり直す必要があります。
これらの差の大きさは、支援先の悪化の85%が延滞として記録されない、という合成データの設定で決まっています。実際にどれだけのラベルが抑えられたかは金融機関ごとに違い、差がここより小さい金融機関も大きい金融機関もありえます。示せたのは差が支援先の捕捉率に集中して現れるという向きまでで、自行で4案のどれが良いかは、自行の延滞・条件変更の履歴で同じ比較をして決めます。
条件変更と区分の履歴が取れるかで、ラベル拡張か除外かを決める
金融機関でこの期間のデータを扱うなら、最初に確かめるのはモデルの設計ではなく、手元の記録です。条件変更の実行日、債務者区分の変更履歴、制度融資の有無と据置期間の終了日を、融資先ごと・観測時点ごとに引き出せるかを確認します。勘定系や自己査定のシステムには最新の状態しか残っていないことがあり、履歴が取れるかどうかで選べる案が決まります。
履歴が取れるなら、ラベルを2種類作ります。延滞だけのラベルと、延滞・条件変更・債務者区分の引き下げのいずれかが12か月以内に起きたら1とするラベルです。学習には後者を使い、2020〜2022年の観測も含めます。前者は、検証で従来の延滞基準と比べるために残します。条件変更のうち、審査を経ずに一律に応じたもの(申し出のあった先への数か月の元金据置など)を区別できるなら、ラベルから外すか別の値にします。
履歴が取れないなら、2020〜2022年は学習から外し、2016〜2019年と2023年以降で学習します。期間フラグを主効果だけで入れる案は採りません。交互作用まで入れるなら除外と結果が近くなるので、説明しやすい除外を選びます。
指標の作り方も変えます。入金の前年同月比は、2021〜2023年は比較の基準が落ち込んでいるので、2019年同月比や、入金の水準そのもの(月商に対する入金の比率など)と併用します。預金残高は、制度融資の残高を差し引いた値も持たせ、借入で増えた残高と稼いで増えた残高を分けます。据置期間の終了日が分かるなら、「返済開始から何か月か」を指標に入れると、返済開始後に悪化が表に出る先を拾いやすくなります。
検証結果は、支援前(2019年まで)、支援期(2020〜2022年)、支援後(2023年以降)に分けて、捕捉率・的中率・リードタイムを並べます。支援期の数字には、延滞が抑制された期間なので参考値であると注記します。全体の数字に加えて、支援を受けた先に絞った捕捉率も出します。合成データで見たとおり、扱い方の差はそこに現れるからです。
2023年以降のデータにも支援の影響は残っている
支援期間を2020〜2022年で区切るのは、説明のための単純化です。2023年1月からは、ゼロゼロ融資の借換えを支える保証制度が始まり、返済負担を長期に分散した先も多くあります。東京商工リサーチの集計では、2024年にゼロゼロ融資を利用したあとに倒産した企業は567件でした。2023年以降の延滞・倒産には、支援を受けずに悪化した先と、支援で先送りされた悪化が表に出た先が混ざっています。
このため、2023年以降の観測を「平常時」として扱ってよいかにも留保が要ります。返済開始後の悪化は、悪化の開始から延滞までの間隔が長く、2019年以前とは延滞に至る経路が違います。2023年以降だけで学習すると、この経路に寄ったモデルになり、支援の影響が薄れたあとの平常時には合わなくなるおそれがあります。期間別の評価を続けて、支援後の数字が支援前の数字に近づいていくかを毎年見ておけば、この経路の違いがいつ消えたかを判断できます。
まとめ
2020〜2022年の延滞データは、悪化した融資先の多くに延滞のラベルが付いていない状態で記録されています。そのまま学習に入れると、モデルは入金の落ち込みを軽く見て、借入で厚くなった預金残高を安全のしるしとして学びます。合成データでは、全体の捕捉率の差は1〜2ポイントと小さく、支援を受けた先の捕捉率と予測延滞率の水準に差が出ました。全体の数字だけを見ていると、この問題は検証で見つかりません。
選び方は手元の記録で決まります。条件変更と債務者区分の履歴が観測時点ごとに取れるならラベルを広げてこの期間も使い、取れないなら学習から外します。どちらの場合も、検証結果は支援前・支援期・支援後に分けて報告します。
次の一手として、過去の延滞先の一覧に、ゼロゼロ融資を含む制度融資の有無と据置期間の終了日を突き合わせてみてください。延滞のうちどれだけが返済開始から1年以内に起きているかが分かれば、この期間の扱いが自社のデータでどれだけ結果を左右するかの見当がつきます。