予兆検知の「何か月前に気づけたか」は、当時まだ届いていない決算書を使うと実際より長く見える
はじめに
予兆検知の提案資料や社内の検証報告には、「延滞や区分の引き下げの平均6か月前に検知できました」という一文がよく載っています。融資先の期中モニタリングを導入するかどうかを決める立場なら、この数字は導入効果そのものに見えます。6か月あれば、資金繰りの相談に乗る、返済条件を見直す、担保や保証の状況を確かめるといった手を打てるからです。
ただ、この「6か月前」(リードタイム)は、過去のデータを後から並べ直して計算した値です。過去の各月について「その月に銀行の手元に何があったか」を正確に再現しないと、まだ届いていない決算書や、まだ決まっていない区分の変更をモデルが先に見てしまいます。こうした未来の情報の混入をリーク(leakage)と呼びます。リークがあると、リードタイムも何割を捕捉できたかも、実際より良く出ます。
この記事では、4,000社×9年の月次の合成データで、同じモデル・同じデータのまま、時点のそろえ方だけを変えて過去データでの検証(バックテスト)を繰り返しました。決算書を「その月が属する事業年度の決算書」と結合するという、データベースではごく自然な結合を1つ入れるだけで、延滞や区分の引き下げを6か月以上前に捕捉できた割合は倍以上に膨らみます。一方で、数字を逆に悪く見せるずれもあり、2つが重なると一見もっともらしい値になることも分かりました。
対象読者:
- 融資先の期中モニタリングや予兆検知モデルの導入・検証を担当する、融資部・審査部・リスク管理部の方
- 予兆検知のバックテストを設計するデータサイエンティスト・アナリスト
- ベンダーや社内から出てきた「〇か月前に検知できた」という数字の妥当性を判断する立場の方
記事のポイント:
- 正しい設計では、延滞や区分の引き下げの6か月以上前に要確認先に入っていた割合は32%です。決算書を事業年度で結合すると70%になり、リードタイムの中央値は測定の上限の12か月に張り付きます
- 学習と評価の間に12か月の空白期間(ギャップ)を設けないと、捕捉率は72%から88%に上がります。リードタイムの中央値はほとんど動かないため、中央値だけを見ていると気づけません
- 債務者区分の引き下げを決算期の日付で記録すると、逆に捕捉率は下がります。数字を良く見せるずれと悪く見せるずれの両方が同時に入ると、検証結果は一見もっともらしい値になります
3月決算のA社は、決算書が届いた6月に初めて要確認先に入った
最初に、1社だけを追います。A社は3月決算の中小企業で、2024年9月に返済が3か月以上滞りました。銀行は毎月、全融資先についてリスクスコアを出し、スコアの高い上位3%(約110社)を要確認先として担当者に渡しています。次の表は、延滞の12か月前からの各月に、A社の数字と、3通りの設計でA社が要確認先に入ったかどうか(●)を並べたものです。
| 月 | 売上入金の前年同期比(直近3か月) | 月末残高(月商の何か月分) | 税・社保の支払い遅れ(直近6か月の回数) | 銀行の手元にある最新の決算書 | 正しい設計 | (a) 決算期末から使う | (b) 事業年度で結合 |
|---|---|---|---|---|---|---|---|
| 2023-09 | +9% | 1.9 | 0 | 2023年3月期(営業利益率+3.7%) | ● | ||
| 2023-10 | +13% | 1.8 | 0 | 同上 | |||
| 2023-11 | +18% | 1.4 | 0 | 同上 | ● | ||
| 2023-12 | +21% | 2.3 | 0 | 同上 | ● | ||
| 2024-01 | +23% | 1.6 | 0 | 同上 | ● | ||
| 2024-02 | +17% | 1.5 | 0 | 同上 | ● | ||
| 2024-03 | +11% | 1.5 | 1 | 同上 | ● | ● | |
| 2024-04 | +5% | 1.2 | 1 | 同上 | ● | ● | |
| 2024-05 | −3% | 1.1 | 1 | 同上 | ● | ● | |
| 2024-06 | −2% | 1.1 | 1 | 2024年3月期(営業利益率−0.3%) | ● | ● | ● |
| 2024-07 | −3% | 0.8 | 1 | 同上 | ● | ● | ● |
| 2024-08 | −5% | 0.5 | 1 | 同上 | ● | ● | ● |
A社の2024年3月期は営業赤字に転じていました。その決算書が銀行に届いたのは3か月後の6月です。正しい設計のモデルは、5月に1.6%だったA社のスコアを、決算書が届いた6月に27%まで引き上げ、A社は初めて要確認先に入りました。延滞の3か月前です。
(a)は、決算書を決算期末の3月から使えたことにした設計です。A社は3月に要確認先に入り、リードタイムは6か月になります。届くまでの3か月を無視しただけで、リードタイムは倍になりました。
(b)は、各月を「その月が属する事業年度の決算書」と結合した設計です。2023年9月は2024年3月期の事業年度の途中なので、まだ締まってもいない赤字決算がこの月の特徴量に入ります。この時期のA社は売上入金が前年より2割近く増えていて、入出金からは悪化の兆しが見えません。それでもA社は要確認先に入り、リードタイムは測定の上限の12か月になります。
実際の運用で起きるのは正しい設計の動きです。このモデルを導入した銀行がA社に気づけるのは延滞の3か月前で、6か月前でも12か月前でもありません。
4,000社×9年の合成データなら、各月に銀行が知り得た情報を再現できる
A社は、ここから説明する合成データの1社です。実在の融資先データは使えないため、2016年1月から2024年12月までの108か月について、4,000社の月次データを生成しました。生成の仕組みを知っているので、各時点で銀行が何を知り得たかを正確に再現でき、ずれの影響だけを取り出せます。
毎月観測できるのは、口座の入出金から作る指標です。売上入金の額、月末残高、税・社会保険料の支払い遅れの有無の3つで、ここから前年同期比、直近の水準と過去12か月平均の比、残高が月商の何か月分か、直近6か月の支払い遅れの回数などを計算します。
決算書は年1回です。決算月は会社ごとに異なり、3月が約4割、12月が約2割、残りを他の月に振り分けました。
この実験では、銀行が決算書を使えるようになるのを決算月の2〜3か月後と仮定しました。法人税の確定申告の期限は事業年度終了の日の翌日から2か月以内(法人税法第74条)で、定款に定めがあれば申告期限の延長の特例で1か月延ばせます(同法第75条の2)。この期限を目安に置いた値で、銀行が実際に決算書を受け取る時期の実績ではありません。提出の時期は融資先と金融機関の運用によって違い、これより遅い先もあります。
銀行は届いた決算書を0〜2か月かけて確認し、営業赤字か自己資本比率10%未満なら要注意先に区分します。銀行のシステムでは、この区分の変更は決定した月ではなく、根拠にした決算期の日付(基準日)で記録されることにしました。
予測の対象は、元本または利息の支払いが3か月以上遅れること(3か月以上延滞)と、決算書をもとに債務者区分を破綻懸念先以下へ引き下げること(ランクダウン)の、早いほうです。以下ではこの2つをまとめて「悪化」と呼びます。引き下げは決算書の確認後に決まるので、引き下げによる悪化の月は決算書の到着より後になります。
業績が落ちていく会社の動きには、次の仮定を置きました。利益が先に減り、その6か月後から入出金が4〜18か月かけて悪くなり、延滞に至ります。悪化の2割は、入出金にほとんど兆しが出ないまま1〜3か月で起きる急なものです。業績が一時的に落ち込んでから回復する会社も混ぜており、これが要確認先の空振りの元になります。5つの乱数シードでデータを作り直し、評価期間(2021〜2024年)の悪化はシードごとに222〜281件でした。
正しい設計は「その月に手元にあったもの」だけでスコアを出す
正しい設計では、各月 のスコアに、月 までに銀行の手元に届いていたデータだけを使います。決算書であれば、到着月が 以前のもののうち最新の1期です。コードでは、決算書ごとにどの日付から使えるかを列で持たせ、その列でずらして結合します。
def asof(fs, N, T, date_col, cols):
    """For each (firm, month): values of the latest statement with date_col <= month."""
    out = {c: np.full((N, T), np.nan) for c in cols}
    for r in fs.sort_values(date_col).itertuples():
        d = max(int(getattr(r, date_col)), 0)
        if d < T:
            for c in cols:
                out[c][r.firm, d:] = getattr(r, c)
    return out
date_col に到着月(arrive)を渡すのが正しい設計です。決算期末(fye)を渡すと(a)に、事業年度の初月(fy_start)を渡すと(b)になります。要注意先の区分も同じ関数で結合し、決定月(decide)を渡すのが正しく、基準日(fye)を渡すとずれが入ります。
モデルはLightGBMの勾配ブースティングで、ラベルは「その月から12か月以内に悪化するか」です。毎年1月に再学習し、その年の12か月は毎月スコアを出します。ラベルは12か月先までを見ているので、2023年12月の行のラベルを確定させるには、2024年12月までの結果が要ります。2024年1月の再学習で使えるのは、ラベルが2023年12月までに確定している2022年12月以前の行だけです。学習に使う最後の行と再学習の月の間に、ラベルの先読みと同じ12か月の空白期間(ギャップ)を設けることになります。
# with the gap, a row's 12-month label must be complete by month R-1
last_row = R - 1 if dz["no_gap"] else R - 1 - HORIZON
tr = df[df["month"] <= last_row]
この手続きで、各年の再学習が実際にどの行を使ったかを、シード0で並べます。
| 再学習の月 | 学習に使う最後の行 | ラベルが見ている最後の月 | 学習の行数 | うち悪化あり | スコアを出す月 |
|---|---|---|---|---|---|
| 2020-01 | 2018-12 | 2019-12 | 83,432 | 1,090 | 2020-01〜2020-12 |
| 2021-01 | 2019-12 | 2020-12 | 130,230 | 1,738 | 2021-01〜2021-12 |
| 2022-01 | 2020-12 | 2021-12 | 176,380 | 2,493 | 2022-01〜2022-12 |
| 2023-01 | 2021-12 | 2022-12 | 221,775 | 3,082 | 2023-01〜2023-12 |
| 2024-01 | 2022-12 | 2023-12 | 266,581 | 3,762 | 2024-01〜2024-12 |
| 2024-01(ギャップなし) | 2023-12 | 2024-12 | 310,707 | 4,495 | 2024-01〜2024-12 |
最後の行が(e)の設計です。ギャップを設けないと、2023年の12か月分(44,126行)が学習に加わります。そこに含まれる悪化ありの733行のうち431行(64社)は、2024年中に悪化する会社の行です。スコアを出そうとしている年の結果を、学習の時点で知っていることになります。
時系列の交差検証で未来のデータが学習に混ざる問題は時系列データの交差検証で扱いました。ここではそれに加えて、ラベルの先読み期間と同じ長さのギャップが必要になります。
評価の指標は3つです。捕捉率は、評価期間に起きた悪化のうち、悪化の12か月前から1か月前までに一度でも要確認先に入っていた割合です。リードタイムは、その期間で最初に要確認先に入った月から悪化の月までの月数で、捕捉できた会社だけで中央値を取ります。12か月より前のアラートは数えないので、上限は12か月です。的中率は、要確認先に入った延べ社数のうち、12か月以内に悪化した割合です。
リークを1つ入れるだけで、6か月以上前の捕捉率は最大で倍以上になる
正しい設計から、リークを1つずつ入れてバックテストを繰り返しました。数値は5シードの平均で、カッコ内はシード間の最小〜最大です。
| 設計 | 捕捉率 | 6か月以上前の捕捉率 | リードタイム中央値 | 的中率 |
|---|---|---|---|---|
| 正しい設計 | 72%(70〜75) | 32%(30〜34) | 4.8か月(4〜5) | 15%(13〜17) |
| (a) 決算書を決算期末から使う | 75%(70〜79) | 32%(29〜35) | 4.6か月(4〜5) | 17%(15〜19) |
| (b) 事業年度の決算書と結合する | 79%(76〜82) | 70%(68〜74) | 12.0か月(12〜12) | 36%(33〜42) |
| (c) 要注意先の区分を基準日で結合する | 74%(70〜77) | 32%(30〜34) | 4.8か月(4〜5) | 16%(14〜18) |
| (d) 区分の引き下げ(悪化)を基準日で記録する | 62%(57〜66) | 27%(23〜31) | 4.5か月(4〜5) | 12%(11〜14) |
| (e) 学習と評価の間にギャップを設けない | 88%(83〜90) | 43%(38〜50) | 5.4か月(5〜6) | 19%(17〜22) |
| (f) 会社ごとの平均を全期間で計算する | 66%(64〜68) | 29%(26〜35) | 5.0か月(4〜6) | 12%(10〜14) |
| (a)+(c)+(e)+(f) | 85%(82〜88) | 43%(40〜49) | 5.4か月(5〜6) | 19%(17〜21) |
悪化の何か月前に要確認先に入っていたかを、月ごとの割合で描くと、ずれの入り方の違いが見えます。
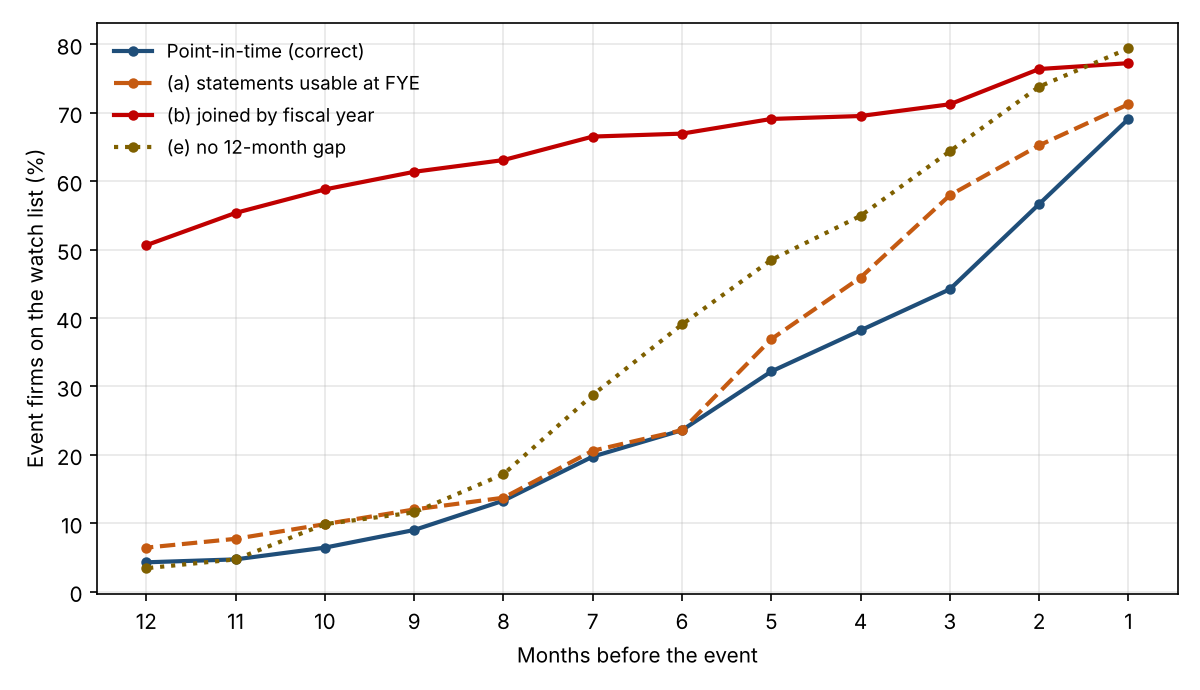
正しい設計では、悪化の1か月前に要確認先に入っている会社は69%、6か月前では24%です。(b)の線は12か月前でも51%あり、悪化に近づいてもほとんど上がりません。まだ届いていない決算書の数字が、どの月の特徴量にもそのまま入っているためです。(a)は2〜5か月前、(e)は1〜8か月前の範囲で、正しい設計をはっきり上回っています。
各月にその事業年度の決算書をつなぐと、6か月以上前の捕捉率は32%から70%に膨らむ
(b)の上振れは突出しています。6か月以上前の捕捉率は32%から70%に、的中率は15%から36%になりました。
決算書の各期に「事業年度」の列があり、月次の表にも「その月が属する事業年度」の列があれば、2つを結合するのは自然な操作です。その結果、各月の特徴量にはその事業年度の終わりの数字、つまり最大で14か月先に届く決算書が入ります。合成データでは利益の落ち込みが入出金より6か月先に始まるので、決算書には延滞の1年以上前から兆しが出ます。モデルはその兆しをそのまま学習します。
決算書を中心にした信用スコアの開発では、年次データを「決算期」で結合する作業に慣れているため、月次のモニタリングに移ったときにこのずれが入りやすくなります。気づく手がかりは、リードタイムが測定の上限に張り付くことと、的中率が不自然に高いことです。
決算期末から使えたことにすると、区分の引き下げだけが早く見える
(a)は全体の捕捉率を3ポイント、的中率を2ポイント上げただけで、リードタイムの中央値は変わりませんでした。ずれが2〜3か月と小さく、要確認先に入った会社の多くは入出金の変化で選ばれているためです。
悪化の種類で分けると、影響の出方は違います。破綻懸念先への引き下げは銀行が決算書を見て決めるので、決算書を早く使えることにすると、モデルが銀行の判断を先回りしたように見えます。引き下げの捕捉率は、正しい設計の70%(64〜78)から80%(76〜84)に上がりました。3か月以上延滞では73%から72%で、差はありません。全体の数字が小さく動くだけでも、決算書で決まる引き下げに限れば差は約9ポイントあります。
学習と評価の間に空白期間を置かないと、捕捉率は72%から88%に上がる
(e)では捕捉率が72%から88%に上がった一方で、リードタイムの中央値は4.8か月から5.4か月にしか伸びていません。新たに捕捉された会社には、悪化の直前に要確認先に入った会社も多く含まれるためです。リードタイムの中央値は捕捉できた会社だけで計算するので、捕捉の母数が増えると水増しが見えにくくなります。「6か月以上前の捕捉率」のように悪化した全社を分母にした指標なら、32%から43%への上振れとして表に出ます。
この設計では、再学習の時点で、評価する年に悪化する会社の直前の行が「悪化あり」として学習に入ります。同じ会社の売上規模や決算書の数字は月をまたいでほとんど変わらないので、勾配ブースティングはその会社を見分けて高いスコアを付けられます。
区分の日付をさかのぼらせたり全期間の平均を使ったりすると、捕捉率が下がる場合もある
区分の日付のずれは、どこに入るかで向きが変わりました。要注意先の区分を特徴量として基準日で結合した(c)は、決定前の区分をモデルが見るので、捕捉率が2ポイント上がります。A社でも、(c)の設計では2024年3月に要確認先に入り、リードタイムは6か月でした。
悪化としての引き下げを基準日で記録した(d)では、捕捉率が62%に下がりました。引き下げに限ると、70%から44%(38〜51)への低下です。引き下げの日付が決算期末までさかのぼり、その根拠になった決算書が届く前に引き下げが起きたことになるためです。銀行が実際に気づいたのは決算書を見た後なので、この記録のまま検証すると、モデルは銀行より遅く、既存の審査は実際より早く気づいたように見えます。
(f)は、売上入金の水準を「その会社の平均」と比べる特徴量で、平均を全期間で計算した設計です。将来の落ち込みを含んだ平均が分母に入るので、未来の情報を含んでいます。それでも捕捉率は66%に下がりました。
全期間の平均と比べた値は、成長している会社では期間の前半に低く後半に高く出るので、同じ値の意味が学習期間と評価期間で変わります。決定木系のモデルがこの特徴量で学習した関係は評価期間では当てはまらず、先読みで得た分より、関係のずれで失った分が大きくなりました。リークはいつも評価を良く見せるわけではなく、向きはデータの作り方で決まります。
4つを同時に入れた最後の行は、捕捉率85%、6か月以上前の捕捉率43%です。(e)を単独で入れたときとほぼ同じ値で、(f)のような下振れが混ざると、上振れの一部が打ち消されます。検証結果が極端な値でないからといって、時点がそろっている証拠にはなりません。
リークごとの膨らみ方は、合成データの作り方に依存しています。特に (a) と (b) の大きさは、利益の落ち込みが入出金の落ち込みより6か月先に始まるという仮定で決まり、この間隔が短い融資先では、リークの影響も小さくなる見込みです。表から読み取ってほしいのはリークの向きと、どの指標に出やすいかであって、実在の金融機関のバックテストがこれだけ水増しされているという推定ではありません。自行の数字がどれだけ動くかは、同じ比較を自行のデータで行って確かめます。
同じ会社のリードタイムが、設計によって1か月から12か月まで変わる
集計した数字が1社ごとにどう出ているかを、シード0の会社で確かめます。数字はリードタイム(か月)で、「−」は12か月前から1か月前までに一度も要確認先に入らなかったことを表します。
| 会社 | 決算月 | 悪化の種類と月 | 正しい設計 | (a) 決算期末から使う | (b) 事業年度で結合 | (d) 引き下げを基準日で記録 | (e) ギャップなし |
|---|---|---|---|---|---|---|---|
| A社 | 3月 | 延滞 2024-09 | 3 | 6 | 12 | 3 | 3 |
| B社 | 3月 | 引き下げ 2022-07 | 1 | 4 | 12 | 2 | 6 |
| C社 | 11月 | 引き下げ 2024-03 | 4 | 4 | 12 | 1 | 4 |
| D社 | 1月 | 延滞 2021-12 | 1 | 3 | 10 | − | 11 |
| E社 | 3月 | 延滞 2022-12 | − | − | − | − | − |
B社は2022年3月期に債務超過になり、決算書が届いたのが5月、破綻懸念先への引き下げが決まったのが7月です。正しい設計では決算書が届いた翌月の6月に初めて要確認先に入り、引き下げの1か月前でした。(a)では決算期末の3月に入り、4か月前に気づいたことになります。
C社は(d)の例です。実際の引き下げは2024年3月でしたが、基準日の2023年11月に記録されると、リードタイムは4か月から1か月に縮みます。D社は(e)の例で、ギャップを設けない2021年1月の再学習が、2020年12月のD社の行を「12か月以内に延滞あり」として学習しています。正しい設計では1か月前にしか要確認先に入らなかったD社が、(e)では11か月前から入っていました。D社は延滞なので(d)でも悪化の日付は変わりませんが、引き下げの日付が変わったことでモデル全体の学習結果が変わり、(d)ではD社を捕捉できませんでした。
E社は延滞の直前まで決算書も入出金も健全で、どの設計でも要確認先に入りません。シード0で正しい設計が見逃した60社のうち、4割強はこうした急な悪化の会社でした。入出金にも決算書にも兆しが出ない悪化は、時点をどうそろえても捕捉できません。
的中率の差は、空振りの多い1社で見ると分かりやすくなります。2021〜2023年の36か月で一度も延滞しなかったF社は、正しい設計では23か月にわたって要確認先に入っていました。一時的な落ち込みを繰り返す会社で、担当者は毎回確認して何も起きないことになります。(b)の設計ではF社が要確認先に入ったのは7か月だけです。将来の決算書の、持ち直した数字が特徴量に入っているためです。
「〇か月前に検知できた」と言われたら、決算書の使い始めと空白期間を確かめる
ベンダーの提案でも社内の検証でも、リードタイムや捕捉率の数字を受け取ったら、まず時点のそろえ方を確かめます。今回の実験で影響の大きかった順に並べると、確認する点は次のとおりです。
- 決算書を、決算期末でも事業年度でもなく、銀行が受け取った日で結合しているか。受領日の記録がなければ、決算月から何か月後に使えたと仮定したか
- 学習に使ったラベルが、スコアを出した期間の悪化を見ていないか。ラベルの先読み期間と同じ長さのギャップを、学習と評価の間に設けているか
- 債務者区分の変更を、決定した月で扱っているか。基準日で記録されたデータなら、特徴量と予測対象の引き下げのそれぞれでどう補正したか
- 会社ごとの平均や業種ごとの分位点など、正規化に使う統計量を、各時点までのデータだけで計算しているか
- リードタイムの中央値だけでなく、悪化した全社を分母にした「6か月以上前の捕捉率」と、要確認先の件数、的中率がそろって出ているか
最後の点は、ずれの有無とは別に必要です。要確認先を毎月何社にするかで、捕捉率もリードタイムも的中率も変わります。上位3%なのか10%なのかが書かれていない捕捉率は、比較の材料になりません。件数は担当者が1か月に確認できる社数から決めるのが実務的で、担当者の確認可能件数から件数を逆算する方法は別の記事で扱っています。
自行で検証を設計する場合、最も手間がかかるのは決算書の受領日と区分の決定日の復元です。融資システムに決算期と基準日は残っていても、その書類がいつ届き、いつ決裁されたかは、別の帳票や稟議の記録にしか残っていないことがあります。検証を始める前に、受領日と決定日をどこまで復元できるかを確認し、復元できない部分は「決算月の4か月後に届いた」のように遅めの仮定を置きます。遅めに置くとリードタイムは短めに出ますが、導入後の実績が検証結果を下回る事態は避けられます。
ずれのない設計で出たリードタイムが短くても、それがこのモデルの実力です。合成データでは、正しい設計の6か月以上前の捕捉率は32%でした。この数字で手を打てる先がどれだけあるかを、要確認先の件数と担当者の工数に照らして見積もり、導入を判断します。
まとめ
4,000社×9年の合成データで予兆検知のバックテストを繰り返し、時点のずれごとの影響を測りました。決算書を事業年度で結合すると、6か月以上前の捕捉率は32%から70%に、的中率は15%から36%になり、リードタイムは上限の12か月に張り付きます。学習と評価の間にギャップを設けないと捕捉率が72%から88%に上がり、決算書を決算期末から使えたことにすると、決算書で決まる区分の引き下げだけが早く捕捉されます。区分の引き下げを基準日で記録すると、逆に捕捉率は下がります。
手元に検証結果があるなら、まず決算書の結合キーが受領日になっているかを確かめ、受領日で結合し直したバックテストを1回実行して元の数字と比べてみてください。その差が、元の数字に含まれていた水増しの大きさです。受領日が残っていなければ、決算月の3か月後と4か月後の2通りで結合し、結果がどれだけ動くかを見るところから始められます。
コード
合成データの生成からバックテスト・集計までのスクリプトです(python script.py で5シードを実行し、4コアで約10分)。図と1社ごとの表は、シード0の結果を保存したファイルから作っています。
"""
Early-warning backtest: how much do non-point-in-time designs inflate
lead time, capture rate and precision?

Synthetic monthly panel of SME borrowers (4,000 firms x 108 months).
  - monthly cash-flow data: sales inflow, month-end balance,
    tax / social-insurance payment delays
  - annual financial statements: fiscal year-end (FYE) month differs by firm,
    the statement reaches the bank 2-3 months after FYE
  - obligor classification "watch": decided after the bank reviews the
    statement, but stored with the FYE as its basis date
  - event = 3+ months past due, or downgrade to "doubtful" decided from a
    statement (whichever comes first)

Designs (each switches on one leak; "correct" has none):
  correct    point-in-time features, 12-month gap, classification by decision month
  fs_fye     (a) statements usable from FYE (no arrival lag)
  fs_fy      (b) each month joined to the statement of the fiscal year it belongs to
  bd_flag    (c) "watch" flag dated by FYE basis instead of decision month
  bd_event   (d) downgrade events dated by FYE basis instead of decision month
  no_gap     (e) training labels overlap the scoring period
  full_norm  (f) per-firm average inflow taken over the firm's whole period
  all        (a)+(c)+(e)+(f)
"""

import sys
import numpy as np
import pandas as pd
import lightgbm as lgb

N_FIRMS = 4000
N_MONTHS = 108            # month 0 = 2016-01, month 107 = 2024-12
HORIZON = 12              # label: event within the next 12 months
TOP_SHARE = 0.03          # each month the top 3% of scores go on the watch list
RETRAIN = [48, 60, 72, 84, 96]   # retrain once a year, score every month
EVAL_EVENTS = (60, 107)   # events evaluated (their 12-month look-back is fully scored)
EVAL_ALERTS = (60, 95)    # alerts evaluated for precision (12-month outcome observed)

BASE = dict(fs="arrive", bd_flag=False, bd_event=False, no_gap=False, full_norm=False)
DESIGNS = {
    "correct":   dict(BASE),
    "fs_fye":    dict(BASE, fs="fye"),
    "fs_fy":     dict(BASE, fs="fy_start"),
    "bd_flag":   dict(BASE, bd_flag=True),
    "bd_event":  dict(BASE, bd_event=True),
    "no_gap":    dict(BASE, no_gap=True),
    "full_norm": dict(BASE, full_norm=True),
    "all":       dict(fs="fye", bd_flag=True, bd_event=False, no_gap=True, full_norm=True),
}


# ----------------------------------------------------------------------
# 1. Synthetic panel
# ----------------------------------------------------------------------
def ramp(t, start, length):
    return np.clip((t - start) / length, 0, 1) * (t >= start)


def simulate(seed):
    rng = np.random.default_rng(seed)
    N, T = N_FIRMS, N_MONTHS
    t = np.arange(T)

    fye_cal = rng.choice(np.arange(1, 13), size=N,     # March and December are common
                         p=np.r_[[0.04] * 2, 0.38, [0.04] * 5, 0.10, 0.04, 0.04, 0.16])
    arr_lag = rng.integers(2, 4, size=N)               # statement arrives 2-3 months after FYE
    rev_lag = rng.integers(0, 3, size=N)               # bank reviews it 0-2 months after arrival
    industry = rng.integers(0, 5, size=N)

    # default episode: profit erodes first, cash follows LEAD_PL months later
    LEAD_PL = 6
    amp = rng.uniform(0.6, 1.4, size=N)
    onset = rng.geometric(0.0013, size=N) + 13
    sudden = rng.random(N) < 0.2
    dur = np.where(sudden, rng.integers(1, 4, size=N), rng.integers(4, 19, size=N))
    e_del = onset + dur                                # 3+ months past due
    cash = np.zeros((N, T)); pl = np.zeros((N, T))
    for i in range(N):
        if onset[i] < T:
            k = 0.4 if sudden[i] else 1.0
            cash[i] = ramp(t, onset[i], dur[i]) * k
            pl[i] = 0.0 if sudden[i] else ramp(t, onset[i] - LEAD_PL, dur[i] + LEAD_PL)
        # temporary dips that recover: the source of false alarms
        for s in rng.geometric(0.004, size=3).cumsum() + 6:
            if s >= T:
                break
            up, down = rng.integers(3, 9), rng.integers(3, 9)
            tri = np.interp(t, [s, s + up, s + up + down], [0, rng.uniform(0.3, 0.8), 0])
            cash[i] = np.maximum(cash[i], tri)
            pl[i] = np.maximum(pl[i], 0.5 * tri)
    cash *= amp[:, None]; pl *= amp[:, None]

    # monthly cash-flow data
    base = rng.lognormal(16, 1.0, size=N)
    season = 0.08 * np.sin(2 * np.pi * (t % 12) / 12)
    ar = np.zeros((N, T)); eps = rng.normal(0, 0.06, size=(N, T))
    for k in range(1, T):
        ar[:, k] = 0.6 * ar[:, k - 1] + eps[:, k]
    trend = rng.normal(0.002, 0.004, size=N)[:, None] * t
    inflow = base[:, None] * np.exp(season + ar + trend - 0.7 * cash)
    balance = (inflow * rng.uniform(0.8, 2.5, size=N)[:, None]
               * np.exp(rng.normal(0, 0.15, (N, T))) * np.clip(1 - 0.85 * cash, 0.05, None))
    tax_delay = rng.random((N, T)) < np.clip(0.02 + 0.45 * cash, 0, 0.8)

    # annual statements, one per FYE
    opm0 = rng.normal(0.03, 0.03, size=N)
    eq = rng.uniform(0.0, 0.4, size=N)
    fs = []
    for k in range(11, T):
        who = np.where(fye_cal == k % 12 + 1)[0]
        opm = opm0[who] + rng.normal(0, 0.01, len(who)) - 0.35 * pl[who, k - 11:k + 1].mean(axis=1)
        eq[who] = eq[who] + 2.0 * (opm - 0.01) + rng.normal(0, 0.01, len(who))
        fs.append(pd.DataFrame(dict(firm=who, fye=k, opm=opm, eq=eq[who].copy())))
    fs = pd.concat(fs, ignore_index=True)
    fs["fy_start"] = fs["fye"] - 11
    fs["arrive"] = fs["fye"] + arr_lag[fs["firm"]]
    fs["decide"] = fs["arrive"] + rev_lag[fs["firm"]]

    # event: delinquency, or a "doubtful" downgrade decided from a statement
    bad = fs[((fs["eq"] < 0) | (fs["opm"] < -0.03)) & (fs["fye"] >= onset[fs["firm"]] - LEAD_PL)]
    first_bad = bad.sort_values("decide").groupby("firm").first()
    event_true = e_del.astype(float); event_basis = e_del.astype(float)
    etype = np.array(["delinquency"] * N, dtype=object)
    for i, row in first_bad.iterrows():
        if row["decide"] < e_del[i]:
            event_true[i], event_basis[i], etype[i] = row["decide"], row["fye"], "downgrade"
    gone = event_true >= T
    event_true[gone] = np.inf; event_basis[gone] = np.inf

    return dict(industry=industry, inflow=inflow, balance=balance, tax_delay=tax_delay,
                fs=fs, event_true=event_true, event_basis=event_basis, etype=etype,
                fye_cal=fye_cal, arr_lag=arr_lag)


# ----------------------------------------------------------------------
# 2. Features as of month t (this is where the leaks enter)
# ----------------------------------------------------------------------
def asof(fs, N, T, date_col, cols):
    """For each (firm, month): values of the latest statement with date_col <= month."""
    out = {c: np.full((N, T), np.nan) for c in cols}
    for r in fs.sort_values(date_col).itertuples():
        d = max(int(getattr(r, date_col)), 0)
        if d < T:
            for c in cols:
                out[c][r.firm, d:] = getattr(r, c)
    return out


def build_features(D, dz):
    N, T = D["inflow"].shape
    inflow, bal = D["inflow"], D["balance"]
    roll = lambda x, w: pd.DataFrame(x.T).rolling(w).mean().to_numpy().T
    shift = lambda x, k: np.concatenate([np.full((x.shape[0], k), np.nan), x[:, :-k]], axis=1)

    in3 = roll(inflow, 3)
    trail = shift(roll(inflow, 12), 3)                 # mean of months t-14 .. t-3
    f = dict(yoy3=np.log(in3 / shift(in3, 12)),
             rel3=np.log(in3 / trail),
             bal_m=bal / trail,
             bal_chg=np.log(bal / shift(bal, 3)),
             tax6=roll(D["tax_delay"].astype(float), 6) * 6,
             log_size=np.log(trail),
             industry=np.repeat(D["industry"][:, None], T, 1).astype(float))
    # level relative to the firm's own average inflow
    if dz["full_norm"]:   # leak: average over the firm's whole observed life
        alive = np.arange(T)[None, :] < np.minimum(D["event_true"], T)[:, None]
        avg = np.nanmean(np.where(alive, inflow, np.nan), axis=1)[:, None]
    else:                 # point in time: average of all months up to t-3
        avg = shift(np.cumsum(inflow, axis=1) / np.arange(1, T + 1), 3)
    f["rel_avg"], f["bal_avg"] = np.log(in3 / avg), bal / avg

    st = D["fs"].copy()
    st["watch"] = ((st["opm"] < 0) | (st["eq"] < 0.1)).astype(float)
    s1 = asof(st, N, T, dz["fs"], ["opm", "eq", "fye"])
    f["opm"], f["eqr"], f["fs_age"] = s1["opm"], s1["eq"], np.arange(T)[None, :] - s1["fye"]
    f["watch"] = asof(st, N, T, "fye" if dz["bd_flag"] else "decide", ["watch"])["watch"]

    event = D["event_basis"] if dz["bd_event"] else D["event_true"]
    firm, month = np.meshgrid(np.arange(N), np.arange(T), indexing="ij")
    df = pd.DataFrame({k: v.ravel() for k, v in f.items()})
    df["firm"], df["month"] = firm.ravel(), month.ravel()
    ev = event[df["firm"].to_numpy()]
    df = df[(df["month"] >= 15) & (df["month"] < ev)].copy()      # firms still active
    df["y"] = (event[df["firm"].to_numpy()] <= df["month"] + HORIZON).astype(int)
    return df, event


FEATS = ["yoy3", "rel3", "bal_m", "bal_chg", "tax6", "rel_avg", "bal_avg",
         "opm", "eqr", "fs_age", "watch", "log_size", "industry"]


# ----------------------------------------------------------------------
# 3. Rolling backtest: retrain yearly, score every month, top 3% = watch list
# ----------------------------------------------------------------------
def backtest(df, dz, seed):
    scored = []
    for R in RETRAIN:
        # with the gap, a row's 12-month label must be complete by month R-1
        last_row = R - 1 if dz["no_gap"] else R - 1 - HORIZON
        tr = df[df["month"] <= last_row]
        model = lgb.LGBMClassifier(n_estimators=200, learning_rate=0.05, num_leaves=31,
                                   min_child_samples=50, subsample=0.8, subsample_freq=1,
                                   colsample_bytree=0.8, random_state=seed, verbose=-1)
        model.fit(tr[FEATS], tr["y"])
        te = df[(df["month"] >= R) & (df["month"] < R + 12)].copy()
        te["score"] = model.predict_proba(te[FEATS])[:, 1]
        scored.append(te)
    s = pd.concat(scored)
    s["alert"] = s.groupby("month")["score"].rank(ascending=False, pct=True) <= TOP_SHARE
    return s


def first_alerts(s, event):
    """First month each evaluated event firm entered the watch list within 12 months before its event."""
    firms = np.where((event >= EVAL_EVENTS[0]) & (event <= EVAL_EVENTS[1]))[0]
    a = s.loc[s["alert"] & s["firm"].isin(firms), ["firm", "month"]]
    a = a[a["month"] >= event[a["firm"].to_numpy()] - HORIZON]
    return firms, a.groupby("firm")["month"].min()


def evaluate(s, event, etype):
    firms, first = first_alerts(s, event)
    lead = event[first.index.to_numpy()] - first.to_numpy()
    pa = s[s["alert"] & s["month"].between(*EVAL_ALERTS)]
    caught = np.isin(firms, first.index)
    return dict(n_events=len(firms),
                capture=caught.mean(),                     # alerted 1+ months before
                capture6=(lead >= 6).sum() / len(firms),   # alerted 6+ months before
                lead_median=float(np.median(lead)),
                precision=pa["y"].mean(),
                capture_dlq=caught[etype[firms] == "delinquency"].mean(),
                capture_dg=caught[etype[firms] == "downgrade"].mean())


if __name__ == "__main__":
    seeds = [int(x) for x in sys.argv[1:]] or [0, 1, 2, 3, 4]
    rows = []
    for seed in seeds:
        D = simulate(seed)
        fin = np.isfinite(D["event_true"])
        print(f"seed {seed}: events {fin.sum()}, downgrade-type {(D['etype'][fin] == 'downgrade').sum()}",
              flush=True)
        keep = {}
        for name, dz in DESIGNS.items():
            df, event = build_features(D, dz)
            s = backtest(df, dz, seed)
            m = evaluate(s, event, D["etype"])
            m.update(seed=seed, design=name)
            rows.append(m)
            print(f"  {name:10s} n={m['n_events']} capture={m['capture']:.3f} "
                  f"capture6={m['capture6']:.3f} lead={m['lead_median']:.1f} "
                  f"prec={m['precision']:.3f} dlq={m['capture_dlq']:.3f} dg={m['capture_dg']:.3f}", flush=True)
            if seed == seeds[0]:
                keep[name] = (s[["firm", "month", "score", "alert", "y"]], event)
        if seed == seeds[0]:
            pd.to_pickle(dict(D=D, runs=keep), f"seed{seed}.pkl")
    res = pd.DataFrame(rows)
    res.to_csv("results.csv", index=False)
    summ = res.groupby("design")[["capture", "capture6", "lead_median", "precision", "capture_dlq", "capture_dg"]].agg(["mean", "min", "max"])
    pd.set_option("display.width", 250)
    print(summ.loc[list(DESIGNS)].round(3).to_string())