エージェント出力の品質を確率で保証する:Conformal Predictionで人手に回す割合を決める

はじめに
エージェントの評価結果が「合格率92%」だと報告されても、そこから決められることはほとんどありません。残りの8%がどの出力なのかは分からないので、いま処理が終わった1件を人の確認なしに通してよいかどうかは、結局その場の勘で決めることになります。
決めたいのは、1件ごとに自動で通すか人に回すかです。そこで、人が採点する前に出力の品質を予測しておき、怪しいものだけ人に回します。どこから怪しいと見なすかの線は、「自動で通した分のうち、品質が目標に届かないものを何%まで許すか」を決めれば計算で出せます。
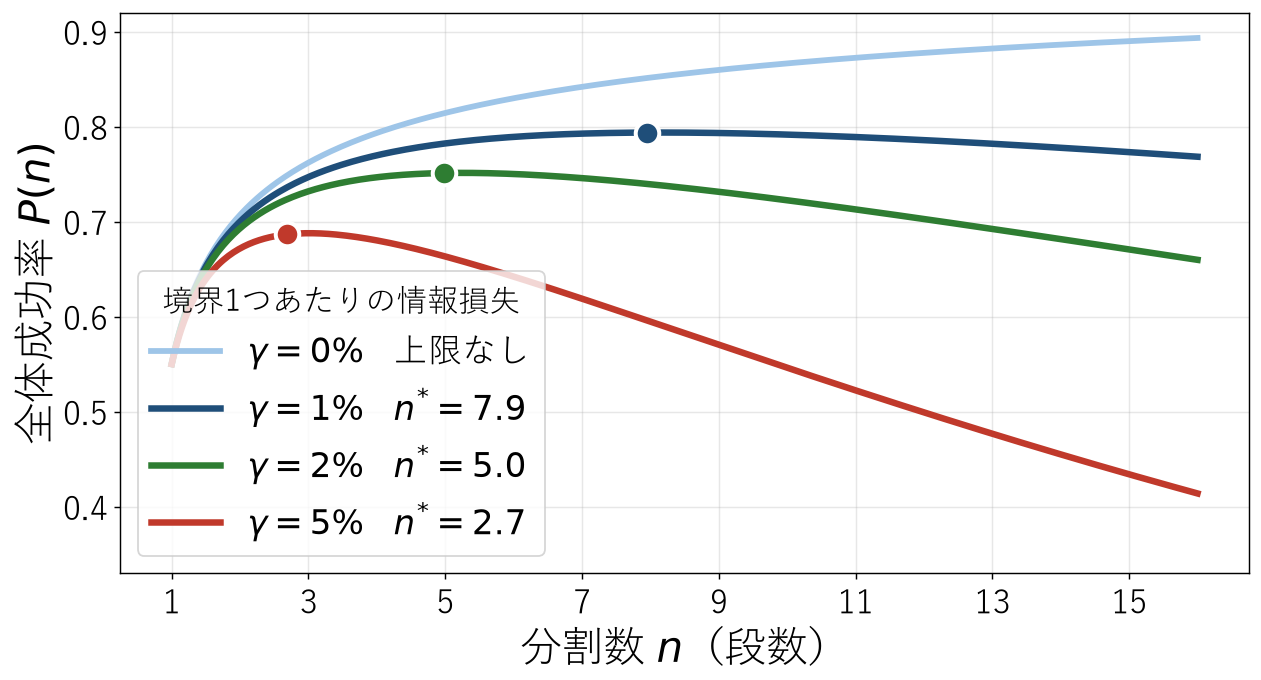
この記事で使う設定では、届かないものを10%まで許すなら、人手に回るのは1割ほどで済みました。許容を半分の5%にすると人手は3倍近くに増え、さらに半分にすると7割近くが人手に戻ります。品質をもう一段上げたいという要求は、そのまま何人ぶんの工数を足すかの話になります。
対象読者:
- LLMエージェントを業務に載せていて、どこまで自動で通すかを決めかねている方
- 「合格率」以外の品質の言い方を探している、評価・品質保証の担当者
- 人手レビューの人員をどこまで減らせるかを見積もりたい事業側の責任者
記事のポイント:
- 出力ごとに品質の下限を付ける片側のConformal Predictionを実装し、被覆率(coverage)が名目どおり出ることを確かめます
- 「自動で通した分の不良率をα以下にする」を直接較正すると、同じ保証でも人手が3分の1で済むことを示します
- 入力分布が変わると保証が崩れることを実験で示し、再較正とオンライン補正の使い分けを整理します
契約書1件を処理して、10項目を返すまで
判断の対象になるものを、1件だけ具体的に見ます。賃貸借契約書のPDFが1件届き、エージェントが必要項目10個を埋めて返す処理です。エージェントは本文から該当しそうな条項を検索し、取れなかった項目については社内の物件マスタを引き直し、それでも埋まらなければ空欄のまま返します。
どの項目をどのツールで取りにいくかは実際にはLLMが選びますが、1回の実行を骨格だけ書くとこうなります。
def run_agent(doc, property_id):
    fields = {k: None for k in REQUIRED}                # 必要項目10個
    for _ in range(MAX_STEPS):
        missing = [k for k, v in fields.items() if v is None]
        if not missing:
            break
        hits = search_clauses(doc, missing)             # 契約書本文から条項を検索
        if not hits:
            hits = search_master(property_id, missing)  # 社内の物件マスタで補う
        fields.update(extract(hits, missing))
    return fields                                       # 10項目のJSONを返す
返ってきたJSONを人が採点します。この1件では契約終期が1年ずれていて、更新料は空欄のままでした。残る8項目は正しく取れています。品質スコアは10項目中8項目で0.8になります。
この2つの誤りは性質が違います。更新料の空欄はJSONを見れば分かるので、機械的に検出してそこだけ人が埋めれば済みます。困るのは契約終期のほうで、日付として体裁が整っているぶん、原本と突き合わせないかぎり1年ずれていることに気づけません。空欄を数えるだけでは品質は測れないので、体裁の整った誤りまで含めた品質を、採点する前に見積もっておきたいわけです。
運用で決めたいのは、この1件を人の確認なしに納品してよいかどうかです。以下では、採点して出たこの0.8を品質スコア 、納品してよいと見なす基準線を品質目標 、採点する前に を当てにいく予測を と書きます。
合格率という報告からは、何を自動で通すかが決まらない
合格率が扱いにくいのは、合否の線をどこに引いたかで数字が動いてしまうからです。ここでいう合格は、項目が埋まっていることではなく、原本と突き合わせて値が正しいことを指します。それでも、10項目のうち9項目まで正しければ合格とするか、10項目すべて正しくないと合格としないかで、合格率は数十ポイント変わります。しかもそれは全体の平均であって、いま処理している1件が合格する確率ではありません。合格率92%と報告されても、その1件を自動で通したときに何が起きるかは分かりません。
判断に使える形にするには、出力ごとの品質と、その品質の不確かさを分けて扱う必要があります。品質スコア は必要項目のうち正しい値が入った割合なので、0から1の連続量として扱えます。品質目標は と置き、 の出力を不良と呼びます。先ほどの8項目正解はちょうど境界の上に乗り、合格側に入ります。
以降の数値は、この処理を模した合成データで出したものです。実行ログから観測できる量と品質スコアの関係を、生成の仕組みごと制御して見たいためで、記事に出てくる割合や件数はすべてその設定のうえでの値です。この設定では、全件を無条件で自動承認すると15.3%が不良でした。
実行時に手元にあるのは手がかりだけなので、それを集めて品質を予測します。入力文書の長さ、必要項目数、検索でヒットした参照の数、ツール呼び出しの再試行回数、モデルの自己申告信頼度を特徴量にして、勾配ブースティングで品質スコアを予測する回帰モデル を作ります。
参照ヒット数と再試行回数は、実行ログに残る量です。検索が1件も引けなかった、ツール呼び出しを2回やり直した、という記録は運用ログとして流されがちですが、品質の手がかりになります。ツールを何段も呼び出す処理は途中で失敗する経路がそのぶん増え、品質のばらつきが大きくなる代わりに、うまく進まなかった過程が記録として残るためです。単発のプロンプトを1回投げるだけの処理に、この記録はありません。出力を見ただけでは分からない品質の差が実行の過程に出るのは、エージェントとして動かしているからです。
学習6,000件で、テスト30,000件に対する平均絶対誤差は0.069、実品質との相関は0.72でした。自己申告信頼度だけを使った場合の相関は0.57なので、モデル自身の申告を鵜呑みにするより、実行ログから観測量を足したほうが予測は当たります。
def generate(n, rng, shift=0.0):
    length = rng.gamma(3.0, 1.0, n)                      # 入力文書の長さ
    n_items = rng.integers(5, 21, n)                     # 必要項目数
    n_refs = np.minimum(rng.poisson(3.0, n), 8)          # 参照のヒット数
    retries = rng.poisson(0.4, n)                        # 再試行回数
    difficulty = (0.35 * (length - 3.0) + 0.06 * (n_items - 12)
                  - 0.18 * n_refs + 0.50 * retries + 0.54
                  + shift + rng.normal(0, 0.40, n))
    p = 1.0 / (1.0 + np.exp(-(2.9 - 1.2 * difficulty)))  # 1項目あたりの成功確率
    conf = np.clip(p + rng.normal(0, 0.12, n), 0.0, 1.0)  # 自己申告信頼度
    y = rng.binomial(n_items, p) / n_items               # 品質スコア
    return np.column_stack([length, n_items, n_refs, retries, conf]), y
出力ごとに品質の下限を付ける
は点予測なので、そのまま閾値と比べても外れたときの保証がありません。ここで欲しいのは上下の区間ではなく下限だけです。品質が予想より高いぶんには困らず、予想より低いことだけが問題になるからです。そこで片側のSplit Conformal Predictionを使います。
学習に使っていない較正データで、非適合スコア(nonconformity score)を過大予測の量 と定義します。その 分位点 を取り、品質下限を とします。テスト点と較正点が交換可能(exchangeable)なら、有限標本で次が成り立ちます。
分位点の取り方と保証の導出はConformal Predictionの入門記事で扱ったので、ここでは実装だけ載せます。
def conformal_slack(f_cal, y_cal, alpha):
    """過大予測 s = f - y の (1-alpha) 分位点。品質下限は L(x) = f(x) - q。"""
    s = f_cal - y_cal
    n = len(s)
    lvl = min(np.ceil((n + 1) * (1 - alpha)) / n, 1.0)
    return float(np.quantile(s, lvl, method="higher"))
較正8,000件で作った下限が、テスト30,000件でどれだけ当たるかを確かめます。
| 名目 | 実測被覆率 | すべり幅 |
|---|---|---|
| 0.80 | 0.7998 | 0.062 |
| 0.90 | 0.9013 | 0.117 |
| 0.95 | 0.9478 | 0.165 |
| 0.99 | 0.9875 | 0.273 |
名目どおりの被覆率が出ています。予測器の性能や品質スコアの分布に何も仮定を置いていないので、この一致自体は設計どおりです。実務でこの表を作る意味は、保証が出たことの確認よりも、すべり幅 を見ることにあります。90%の下限を出すには予測値から0.117引く必要があり、95%なら0.165引きます。予測器の精度がそのまま、下限を引き下げる幅として目に見えます。
下限が手に入れば、選択的予測(selective prediction)の形に持ち込めます。 の出力だけ自動で承認し、届かないものは人に回します。 とすると閾値は となり、人手に回るのは42.6%でした。通した分の実測不良率は3.1%です。目標の10%は満たしているものの、実際には3分の1以下まで下がっていて、そのぶん人手へ回しすぎています。
下振れするのは、 が全件を混ぜた分位点だからです。難しい入力では過大予測が大きく、簡単な入力では小さいのに、すべての入力から同じ幅を引いています。自動承認されるのは簡単な入力ばかりなので、そこに難しい入力ぶんの余裕まで上乗せされます。この保証はあくまで全体(marginal)に対するもので、承認した部分集合に対するものではありません。
通した分の不良率を直接較正する
運用として約束したいのは「自動で通した出力のうち、品質目標を下回るものが 以下」という条件つきの量です。それなら、その量を直接較正できます。
閾値 の候補をグリッドに並べ、較正データのうち となったものの不良率に、二項分布のClopper-Pearson上側信頼限界を取ります。その上限が 以下になる閾値のうち、最も緩いものを選びます。候補をすべて検定するのでBonferroniで多重性を補正します。
def calibrate_accept_threshold(f_cal, y_cal, alpha, delta=0.05, n_grid=40):
    """受理分の不良率 P(y < TAU | 受理) <= alpha を確率 1-delta で満たす閾値。"""
    bad_cal = (y_cal < TAU)
    grid = np.quantile(f_cal, np.linspace(0.02, 0.98, n_grid))
    conf = 1.0 - delta / n_grid
    best = np.inf
    for t in grid:
        acc = f_cal >= t
        n_acc, k = int(acc.sum()), int(bad_cal[acc].sum())
        if cp_upper(k, n_acc, conf) <= alpha:   # 上側信頼限界
            best = min(best, float(t))
    return best
較正8,000件で、グリッドの一部を並べるとこうなります。
| 閾値 | 受理件数 | うち不良 | 不良率 | 上側信頼限界 | 以下か |
|---|---|---|---|---|---|
| 0.734 | 7,446 | 777 | 10.4% | 11.5% | × |
| 0.777 | 7,249 | 659 | 9.1% | 10.2% | × |
| 0.805 | 7,052 | 574 | 8.1% | 9.2% | ✓ |
| 0.825 | 6,855 | 496 | 7.2% | 8.2% | ✓ |
| 0.843 | 6,658 | 430 | 6.5% | 7.4% | ✓ |
0.777の行が、上側信頼限界を取る意味を示しています。較正データで測った不良率は9.1%で目標を下回っていますが、7,249件から測った9.1%には誤差があり、真の不良率が10%を超えている可能性が残ります。その可能性まで含めた上限が10.2%なので、この閾値は宣言に使えません。✓が付いた閾値のうち、いちばん緩い0.805を選びます。0.825や0.843でも約束は守れますが、受理件数が減るぶん人手が無駄に増えるだけです。
conformalの は較正データを引き直すことも含めた平均としての確率でしたが、こちらは「較正データの引きが悪くなければ、確率 で不良率が 以下」という主張で、保証の型が変わっています。運用の約束としては後者のほうが宣言しやすく、監査でも説明が通ります。代わりに、 ぶんだけ上限を厳しめに取ることになります。
この閾値をテスト30,000件に当てると、人手に回るのは11.8%、通した分の実測不良率は8.5%でした。同じ約束を、下限で判定したときのおよそ3分の1の人手で果たせています。
2つの閾値が1件ごとの判定をどう変えるかを、テストデータから6件抜き出して並べます。下限で判定する方式()をA、受理集合を直接較正した方式()をBとします。実品質 は、人が採点して事後的に分かった値です。
| 正解項目 | 実品質 | A: 下限で判定 | B: 直接較正 | |
|---|---|---|---|---|
| 0.959 | 8 / 8 | 1.000 | 自動 | 自動 |
| 0.897 | 10 / 12 | 0.833 | 人手 | 自動 |
| 0.895 | 9 / 9 | 1.000 | 人手 | 自動 |
| 0.843 | 13 / 17 | 0.765 | 人手 | 自動 |
| 0.791 | 16 / 17 | 0.941 | 人手 | 人手 |
| 0.659 | 7 / 10 | 0.700 | 人手 | 人手 |
2行目と3行目が、Aで人手が膨らむ理由そのものです。どちらも実際には品質目標を満たしていて、3行目は9項目すべて正解でした。それでもAは人手に回します。 が0.9近くあっても、そこから全件共通のすべり幅0.117を引くと0.8に届かないためです。Bはこの2件を自動で通します。
4行目がBの許容枠の中身です。17項目のうち正しかったのは13項目で、品質は0.765の不良でした。Bはこれを自動で通しています。約束しているのは通した集団の不良率が10%以下であることなので、この1件が通ること自体は保証の破れではありません。10%枠を使うとはこういう出力が混じることだと、承認の前に合意しておく必要があります。5行目はBでも人手に回る良品で、Bが人手に回す11.8%のなかにも、この種の余分な確認は残ります。
同じ判定を全件で見ると次の図になります。保証を強めた で描いてあり、閾値はAが0.965、Bが0.895です。

保証を1段強めると、人手は何倍になるか
許容する不良率 を動かして、人手に回る割合と実測の不良率を並べます。

どちらの方式も約束は守っています。違うのは目標をどれだけ下回るかで、下限で判定する方式は実測が目標の3分の1程度に落ち、その代償として人手が2倍から3倍に膨らみます。 まで下げると必要な閾値が1.0を超えるので、全件を人手に回すほかありません。予測値の最大が1.0である以上、 を満たす入力が無くなるからです。宣言できる保証水準に天井があるので、この方式は運用の要求に追随しにくくなります。
直接較正のほうを、人手の工数に換算します。月2万件を処理し、人が1件確認するのに7分かかる想定です。
| 許容する不良率 | 人手に回る割合 | 実測不良率 | 人時/月 | 常勤換算 |
|---|---|---|---|---|
| 15% | 4.0% | 12.3% | 93 | 0.6人 |
| 10% | 11.8% | 8.5% | 275 | 1.7人 |
| 5% | 31.4% | 4.3% | 733 | 4.6人 |
| 3% | 54.2% | 2.3% | 1,264 | 7.9人 |
| 2% | 68.4% | 1.6% | 1,595 | 10.0人 |
15%から10%への引き締めは0.6人から1.7人で、まだ現場の裁量で吸収できます。10%から5%にすると4.6人になり、5%から2%ではさらに倍になって10人です。曲線が凸なので、品質目標を上げるほど1ポイントあたりの追加人員が増えていきます。
この表があると、品質の議論を人員の議論として進められます。「不良を5%以下に抑えたい」という要求に対して、「では常勤4.6人ぶんのレビュー体制が要ります」と返せます。逆に「レビューは2人までしか出せない」という制約からは、宣言できる保証はおよそ9%だと逆算できます。人が1件見る手間と、不良を1件通したときの損失を金額に直せるなら、どこで止めるかは期待損失を最小にする問題として解けます。
曲線の位置を決めているのは予測器 の識別力なので、レビュー人員を減らす手立ては人員交渉だけではありません。 の当たりが良くなれば曲線全体が下に動きます。エージェント本体の改善と、品質を予測する側の改善は別の作業で、後者のほうが安く済むことがよくあります。
較正データの件数が、宣言できる保証の上限を決める
較正データを部分抽出して、件数を変えたときに何が宣言できるかを見ます。各セルは30回の抽出のうち閾値が見つかった割合と、そのときテストで人手に回った割合の平均です。
| 較正件数 | =10% | =5% | =3% | =2% |
|---|---|---|---|---|
| 500 | 100% / 23.2% | 27% / 60.5% | 0% / 不可 | 0% / 不可 |
| 1,000 | 100% / 17.0% | 80% / 49.3% | 10% / 65.2% | 0% / 不可 |
| 2,000 | 100% / 13.9% | 100% / 40.3% | 43% / 65.6% | 3% / 68.7% |
| 4,000 | 100% / 11.9% | 100% / 34.3% | 100% / 62.1% | 10% / 69.1% |
| 8,000 | 100% / 11.8% | 100% / 31.4% | 100% / 54.2% | 100% / 68.4% |
500件では を1度も宣言できませんでした。データが足りないと、不良率が本当に低い閾値を選んでも、上側信頼限界がそこまで下がらないためです。 なら500件でも宣言できますが、人手は23.2%で、8,000件のときの倍かかります。較正データが少ないぶんの不確かさを、余分な人手で埋めている形になります。
較正データは人が採点したラベルつきの出力なので、増やすには実際の工数がかかります。厳しい保証を出したいという要求が来たときに最初に足りなくなるのは、たいていモデルの性能よりもラベルの枚数のほうです。何件あれば何が言えるかの見積もりは、評価データセットの件数を検出力から決める話と同じ計算に乗ります。
入力の顔ぶれが変わると保証は崩れる
ここまでの保証はすべて交換可能性(exchangeability)に乗っています。較正時の入力とこれから来る入力が同じ母集団から来ている、という仮定です。エージェントの運用では、この仮定は次のような場面で崩れます。新しい業種や新しい書式の文書が入ってくれば入力分布が変わりますし、基盤モデルを差し替えたりプロンプトを書き換えたりすれば の意味自体が変わります。ツールの仕様変更で参照ヒット数の分布が動くこともあります。
5週目から入力が段階的に難しくなる状況を作り、3つの運用を比べます。較正したきりで放置する場合、毎週500件にラベルを付けて直近4週分で閾値を引き直す場合、毎週300件だけ通した出力を監査して閾値を上下させる場合です。3つ目は適応的conformal(adaptive conformal inference)と同じ更新則を閾値に当てたもので、監査で測った不良率が目標を超えていれば閾値を上げ、下回っていれば下げます。

放置した場合、7週目以降の不良率は平均16.8%で、目標の10%を大きく超えました。人手に回る割合は14.4%のまま動きません。保証は破れているのに、運用のダッシュボード上で見えるのは「人手に回る件数が少し増えた」程度で、品質が落ちたことは何も表示されません。ラベルを取り続けないかぎり、破れたこと自体が観測できません。
毎週の再較正では不良率は8.2%に収まりましたが、人手は41.2%まで上がりました。オンライン補正は不良率10.5%、人手30.7%です。再較正のほうが人手が多いのは、直近4週分の2,000件から毎回上側信頼限界を取り直すので、標本が少ないぶんの上乗せを毎回払うためです。オンライン補正は有限標本の保証を持たず、長期の平均を目標に寄せるだけなので、その上乗せが要りません。
どちらを選ぶかは、ラベルをどれだけ供給できるかで決まります。採点の体制があるなら再較正が確実で、監査しか実施できないならオンライン補正で日々の追随をしつつ、四半期に一度は較正データを取り直して引き直す運用になります。信用スコアリングの運用でも、モニタリング指標は毎月見るものの、スコアカードの再構築は年単位で行います。頻度の違う2つのループを併走させる考え方は、そのままここでも使えます。
この設計を持ち込む前に確かめること
まず確かめるのは、品質を1本の連続量として書けるかどうかです。必要項目のリストに対する充足率のように数えられる指標ならそのまま乗りますが、文章の自然さのような主観評価しかない場合は、採点基準を数えられる形に落とすところから始まります。合否の二値しか取れないなら、品質下限の話は消えて、通した分の不良率を直接較正する部分だけが残ります。それでも運用上は十分に使えます。
棄却された分の受け皿も先に決めておきます。人手に回る割合が11.8%から31.4%に増えるとき、レビュー担当が本当にその件数をさばけるのかは別の問題で、さばけなければ待ち行列が伸びて納期が崩れます。処理能力に上限があるなら、最適化の変数は から「1日に人が見られる件数のなかで、どの出力を優先して見るか」に変わります。
保証の意味も取り違えないようにします。ここで担保しているのは通した集団の不良率であって、1件ごとの安全ではありません。1件の誤りが取り返しのつかない結果を生む出力に対しては、割合の保証は答えになりません。そうした出力は の設計から外し、全件確認か、そもそも自動化しない判断を別枠で置きます。
まとめ
エージェントの品質を合否の二値で語るのをやめると、品質目標を人員数で表せます。今回の設定では、通した出力の不良を10%まで許すなら人手は11.8%、5%なら31.4%、2%なら68.4%で、月2万件の処理なら常勤1.7人から10.0人までの幅になりました。この対応表があれば、「品質をもう一段上げたい」という要求に対して、必要な人員と、代わりに諦める自動化率を数字で返せます。
前提はいくつもあります。品質を採点したラベルが数千件は要りますし、入力分布が動けば保証は静かに崩れて、採点を続けていなければ崩れたことにも気づけません。それでも、合格率92%という報告よりは、意思決定に使える形になっています。手元にエージェントの実行ログと採点済みの出力があるなら、まず品質スコアを予測する回帰を1本作り、この記事の閾値較正を通して、いまの運用が何%の不良率を宣言できる状態にあるかを出してみてください。その数字が、自動化をどこまで広げられるかの出発点になります。